高级数据搬运:TMA、Swizzle 与不规则访问
第 2 章将 dma.copy 介绍为鳄霸(Croqtile)的通用数据搬运原语——一种使用简单的 src => dst 箭头语法在存储空间之间搬运矩形 tile 的方式。在底层,DMA 拷贝是软件驱动的:warpgroup 中的每个线程都参与地址计算与载入发射。硬件看到的是每个线程一条独立的 load 指令,它们共同在 shared memory 中拼出一个 tile。
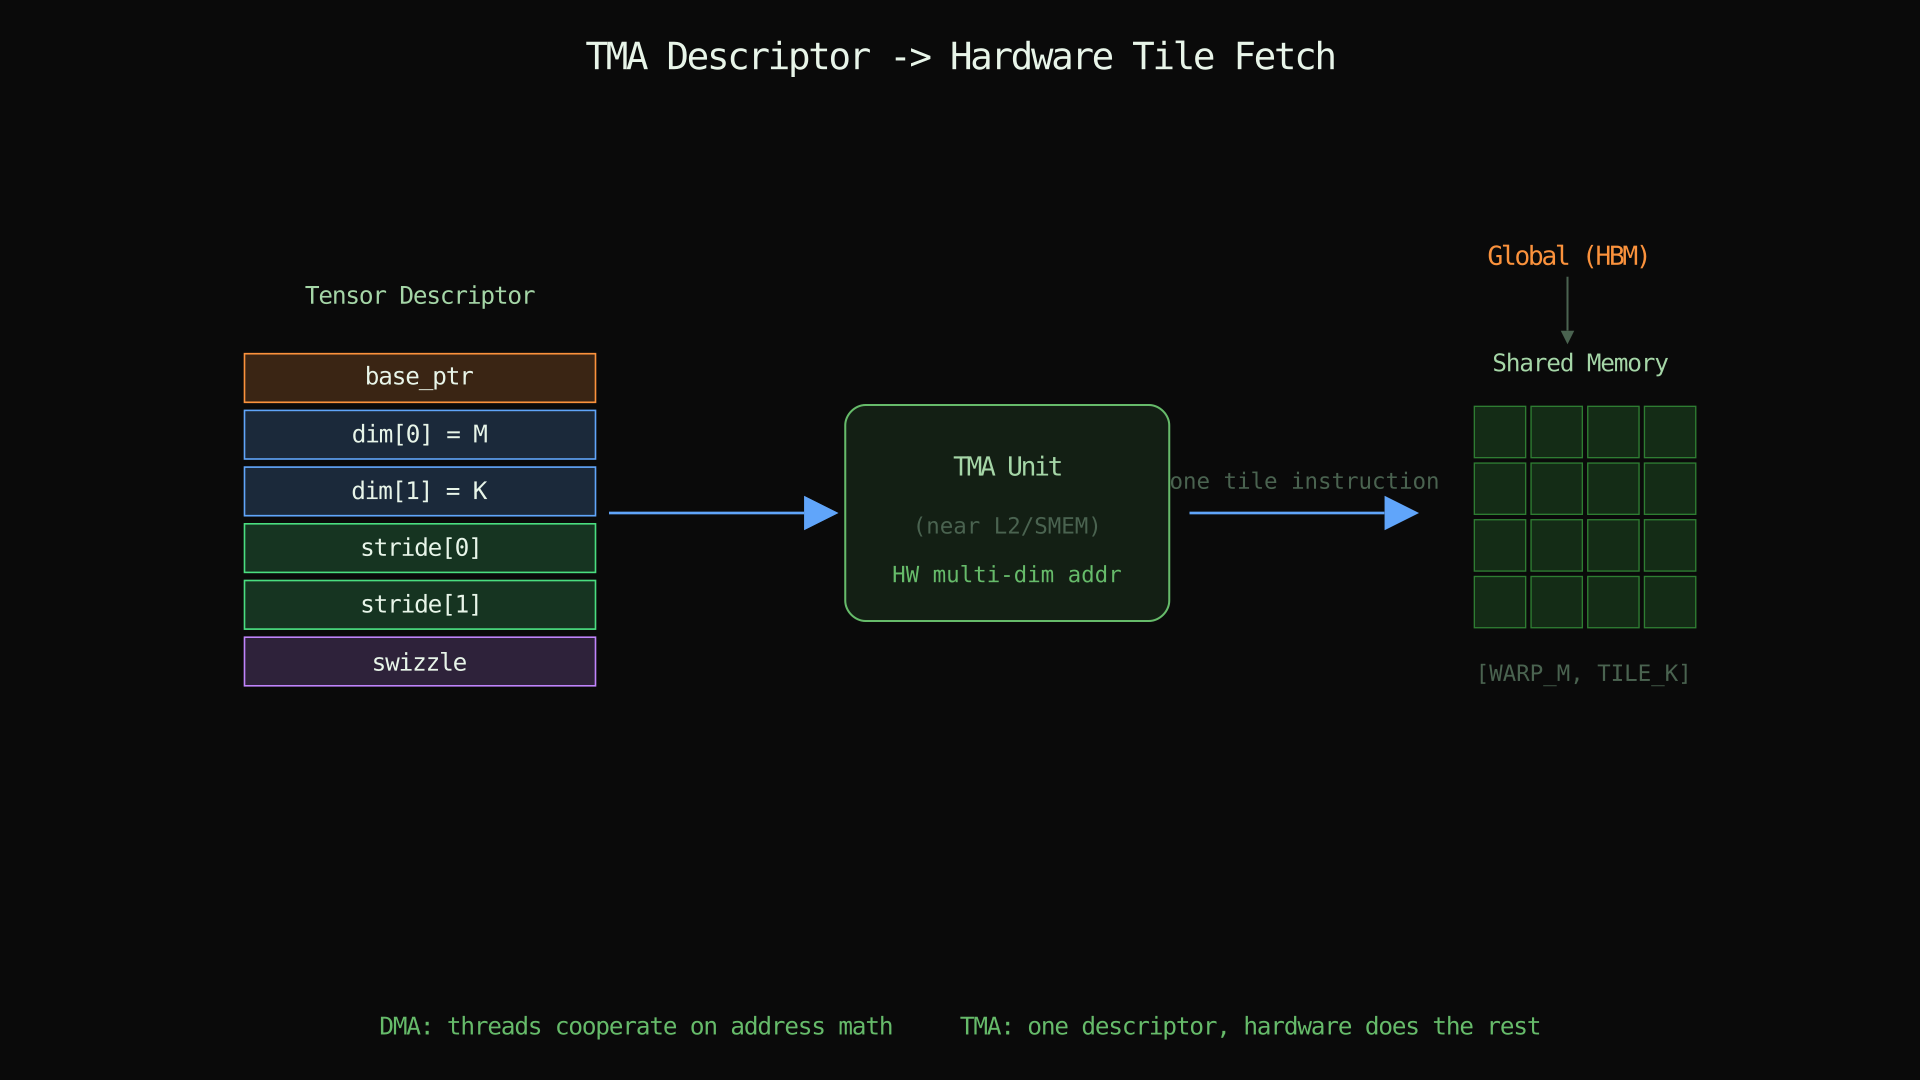
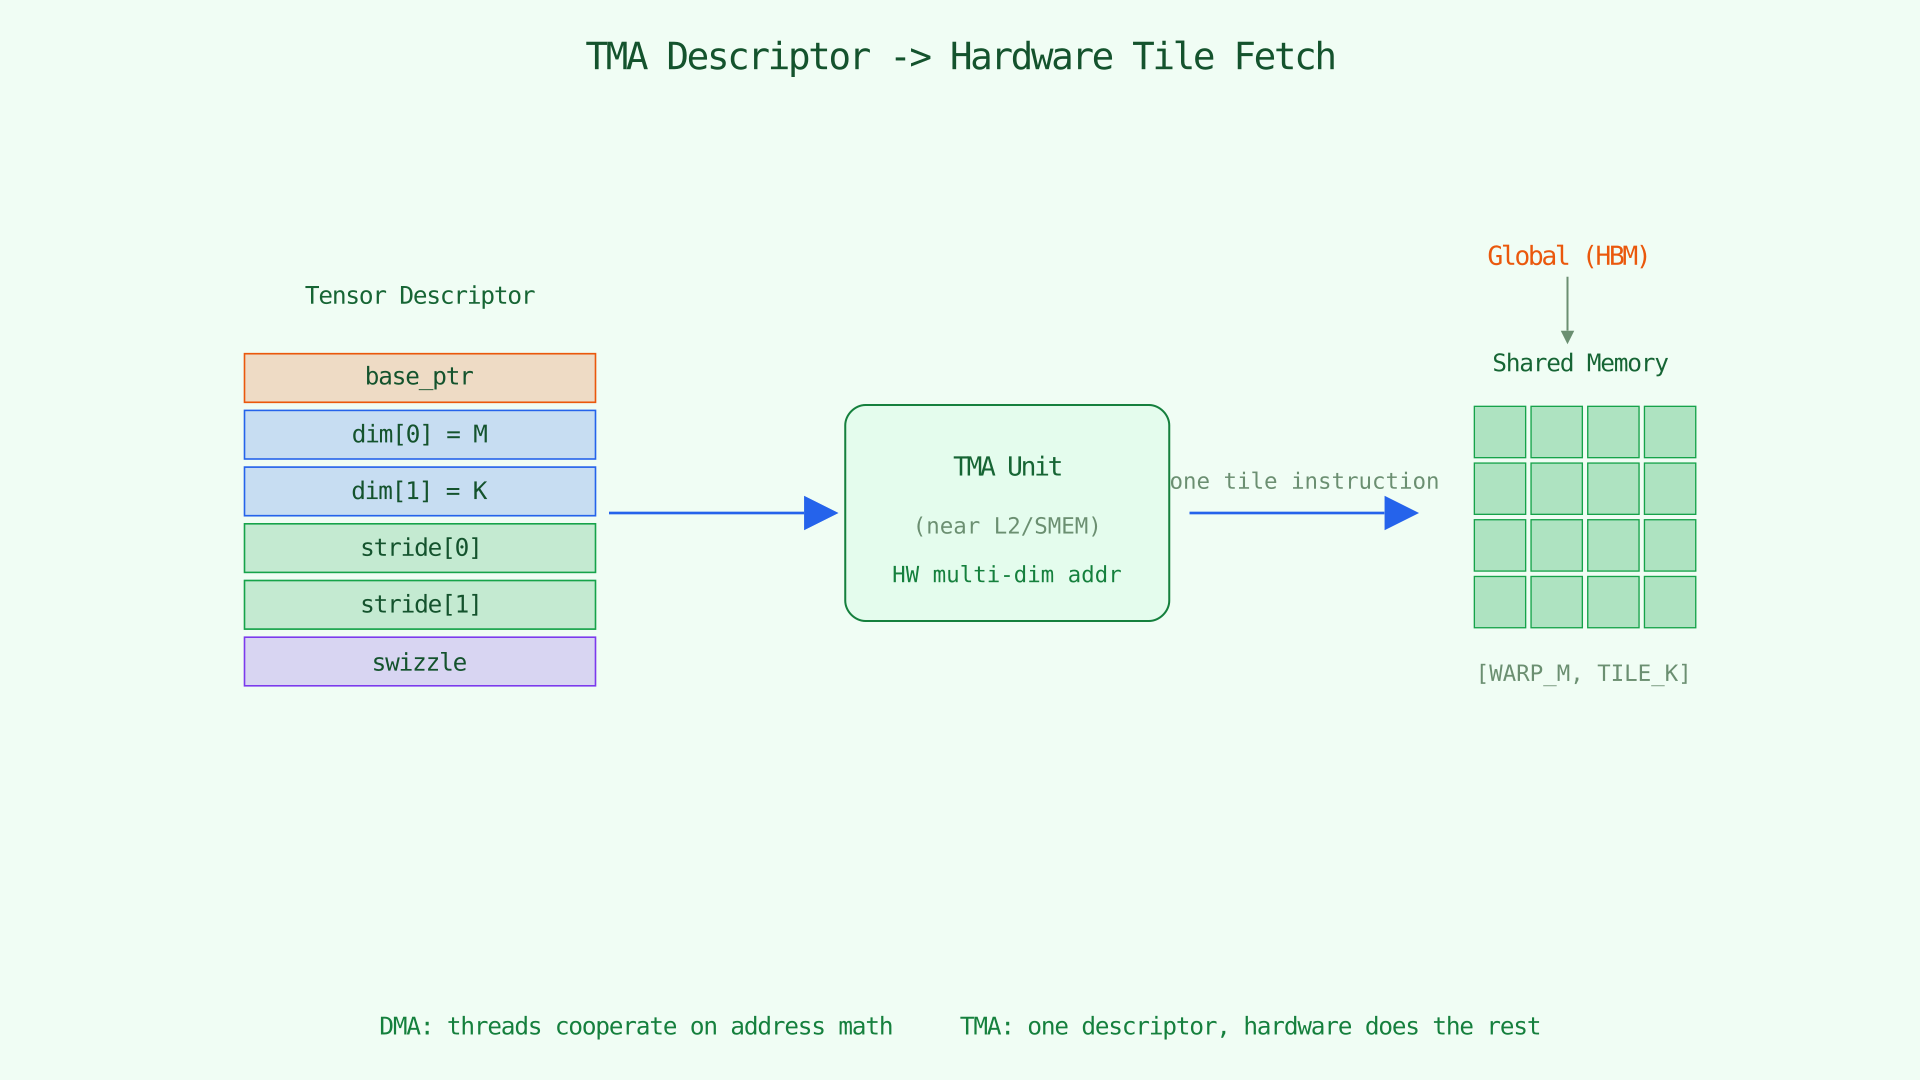
NVIDIA 的 Hopper GPU(SM90+)增加了第二种机制:Tensor Memory Accelerator (TMA)。TMA 是位于 L2 cache / shared memory 接口附近的物理硬件单元。与线程协作发射 load 不同,单个线程发出一条基于描述符的指令,TMA 引擎负责其余一切:多维地址计算、边界钳位以及实际数据传输。
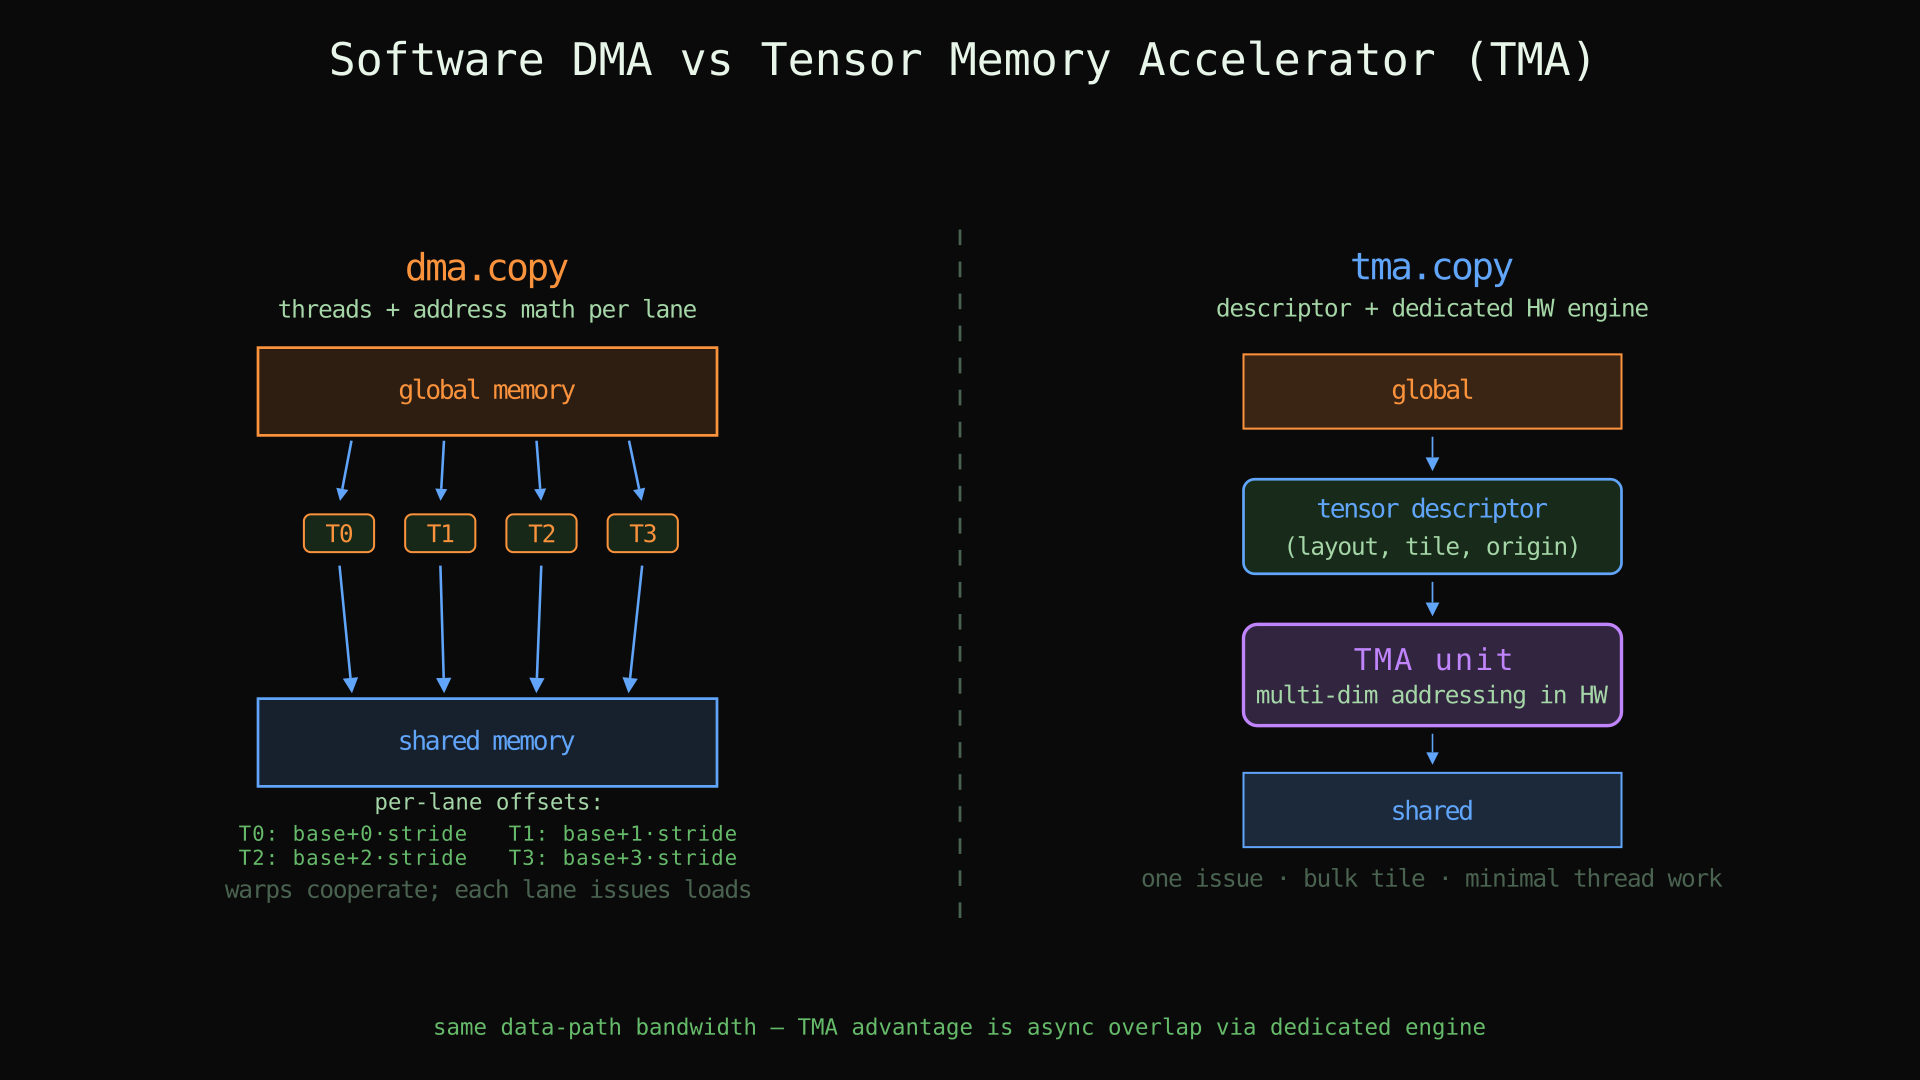
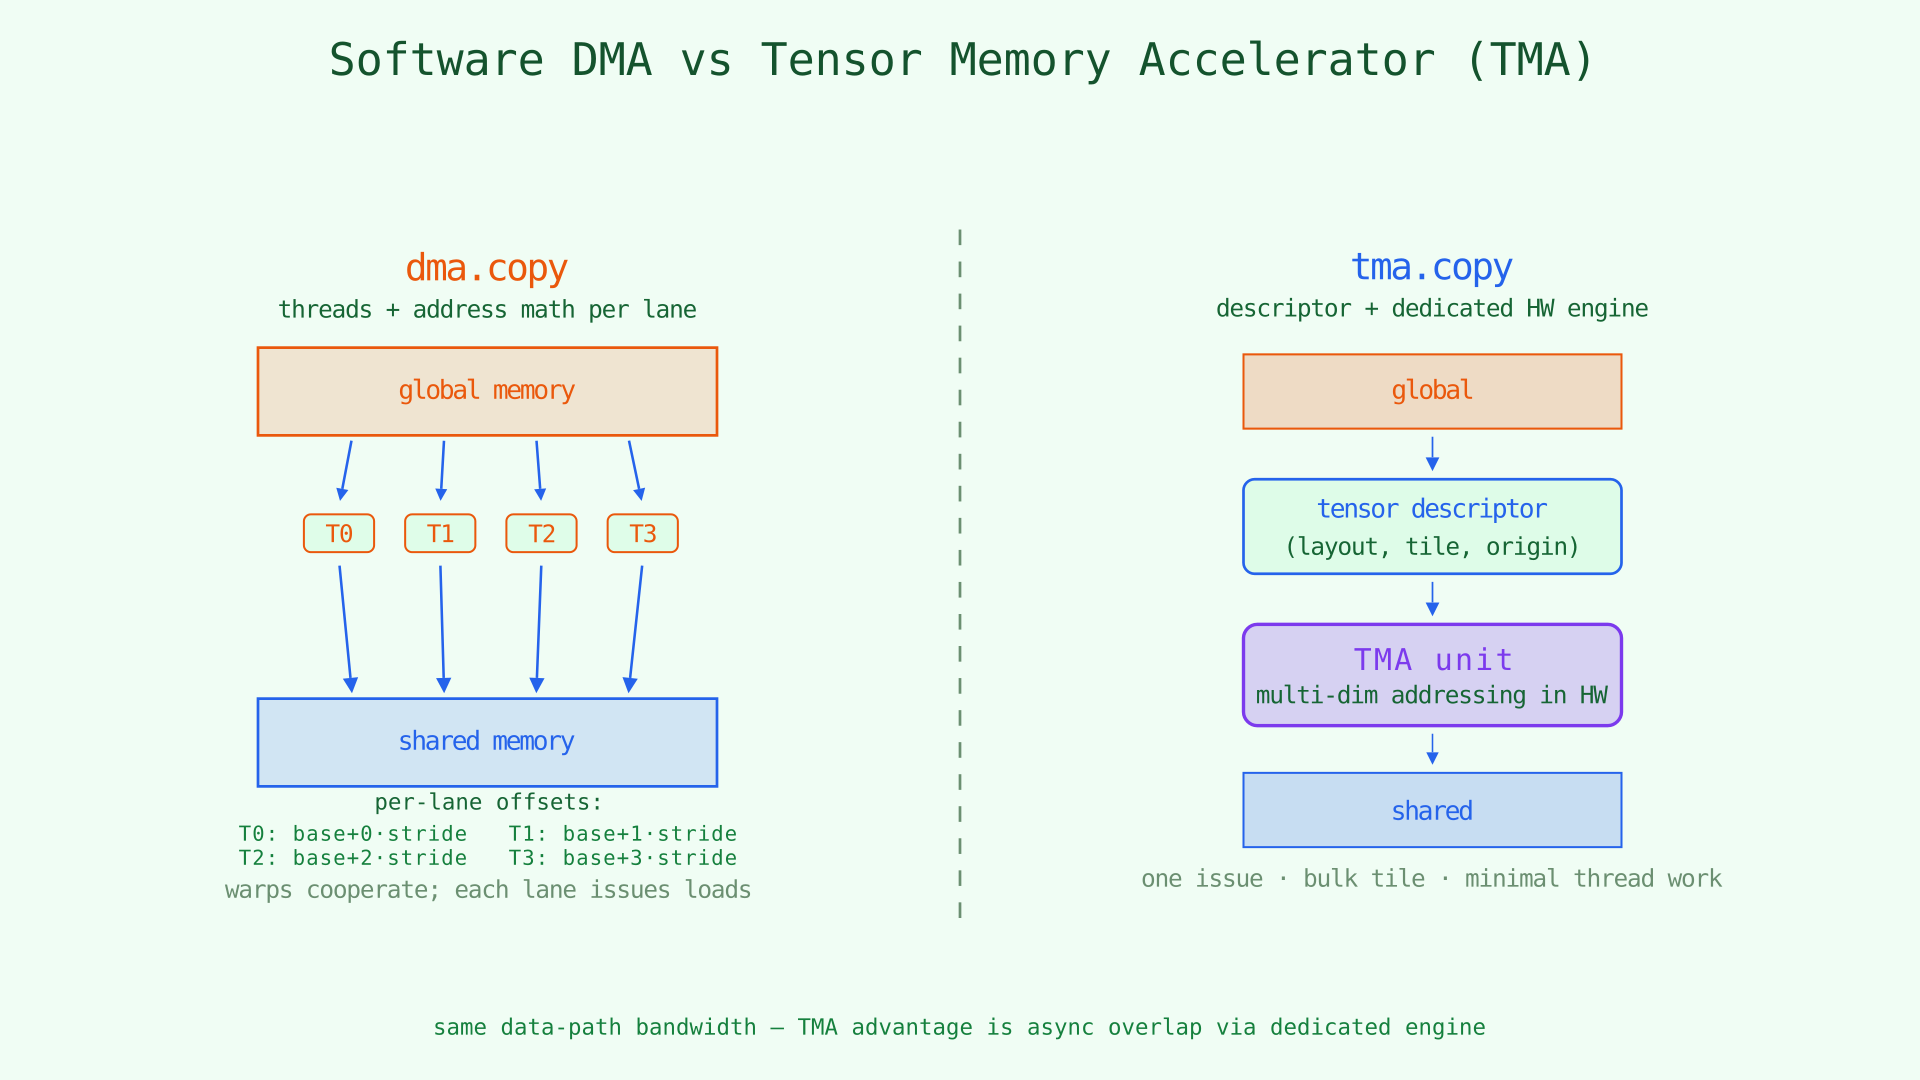
一个常见误解是 TMA 比 DMA 搬运数据更快。事实并非如此——两条路径最终走的是相同的 HBM → L2 → shared memory 数据通路,带宽相同。优势在别处:TMA 拥有独立的专用引擎,独立于 SM 的指令流水线运行。一旦描述符指令发出,TMA 硬件在后台完成传输,发出指令的线程(以及 warpgroup 中的所有其他线程)可以自由执行计算指令。使用 dma.copy 时,参与地址运算与 load 发射的线程在传输期间被占用;使用 tma.copy 时,它们可以将传输与 MMA 或其他工作重叠。在 warp 特化流水线(第 5–6 章)中,这就是生产者阻塞等待 load 与 fire-and-forget 之间的差别。
两条路径的差异在于接口,而非吞吐:
dma.copy— 线程协作发射 load。程序员无需控制地址模式——鳄霸自动处理合并访存。灵活:编译为标准 load 指令,可在任何 CUDA GPU 上运行。tma.copy— 一条基于描述符的指令。TMA 硬件将其展开为多维寻址、应用 swizzle 并处理边界钳位。仅限 Hopper(SM90+)。描述符由编译器根据__co__签名与全局布局构建。
鳄霸通过与 DMA 相同的箭头语法暴露 TMA——用 tma.copy 代替 dma.copy。本章其余部分介绍 TMA、swizzle、处理现实边界情况的不规则访问工具,以及鳄霸如何用受限的可表达能力换取确定性的高性能。
tma.copy:硬件张量搬运
表面语法与 dma.copy 一致:
tma.copy lhs.subspan(WARP_M, TILE_K).at(block_m, iv_k) => lhs_load_s;相同的源表达式,相同的 => 目标形式。区别在于由谁完成工作:
- DMA 路径。 线程协作覆盖 tile;每条 lane 参与地址运算与 load 发射。吞吐量取决于你能在多大程度上让这些 load 对 bank 友好。
- TMA 路径。 一次基于描述符的操作描述张量切片;TMA 硬件将其展开为多维寻址,并将整个 tile 作为单元搬运。生产者线程可与其他工作重叠,因为拥有传输的是硬件,而非一整 warp 的线程。
收益。 你仍对整个 tile 同步(通过事件或第 6 章中的流水线纪律),但省去了逐线程的 load 编排。编译器根据你的 __co__ 签名与全局布局构建张量描述符。
Swizzle 与 bank 冲突
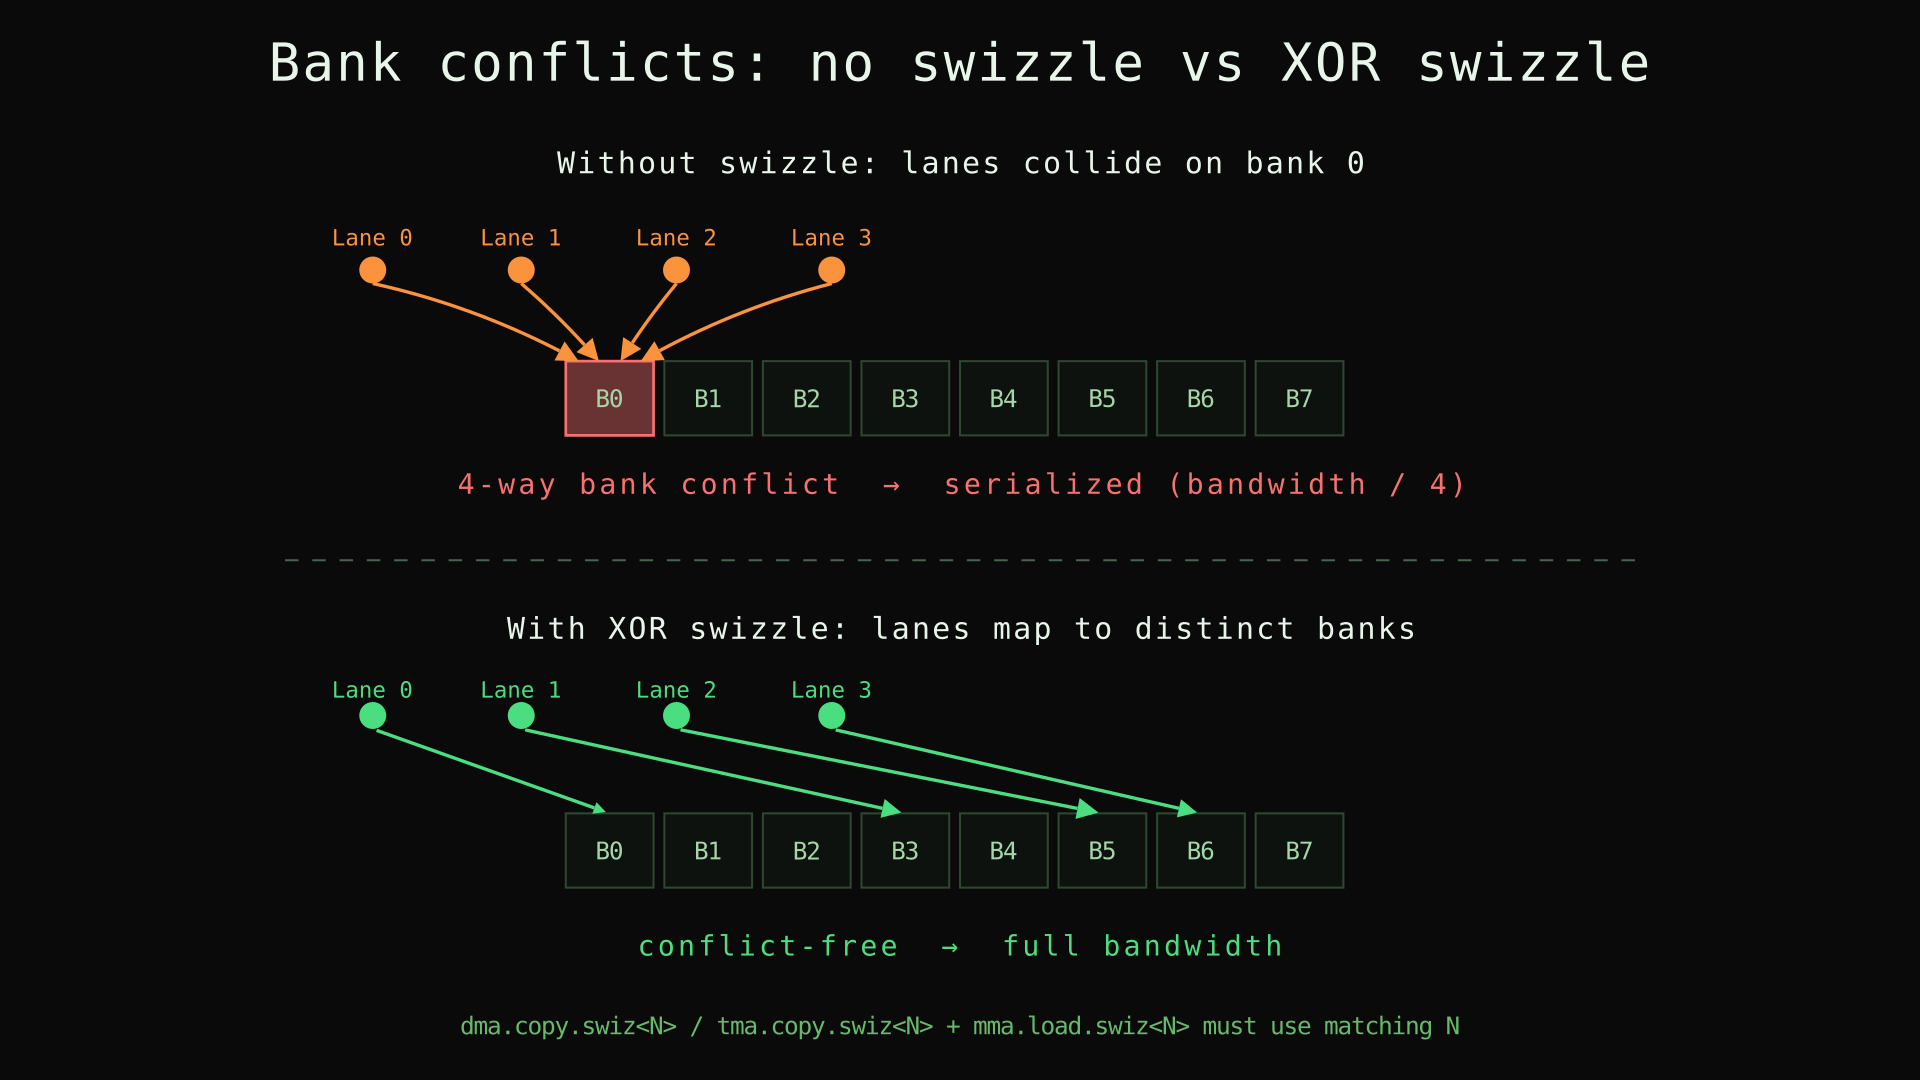
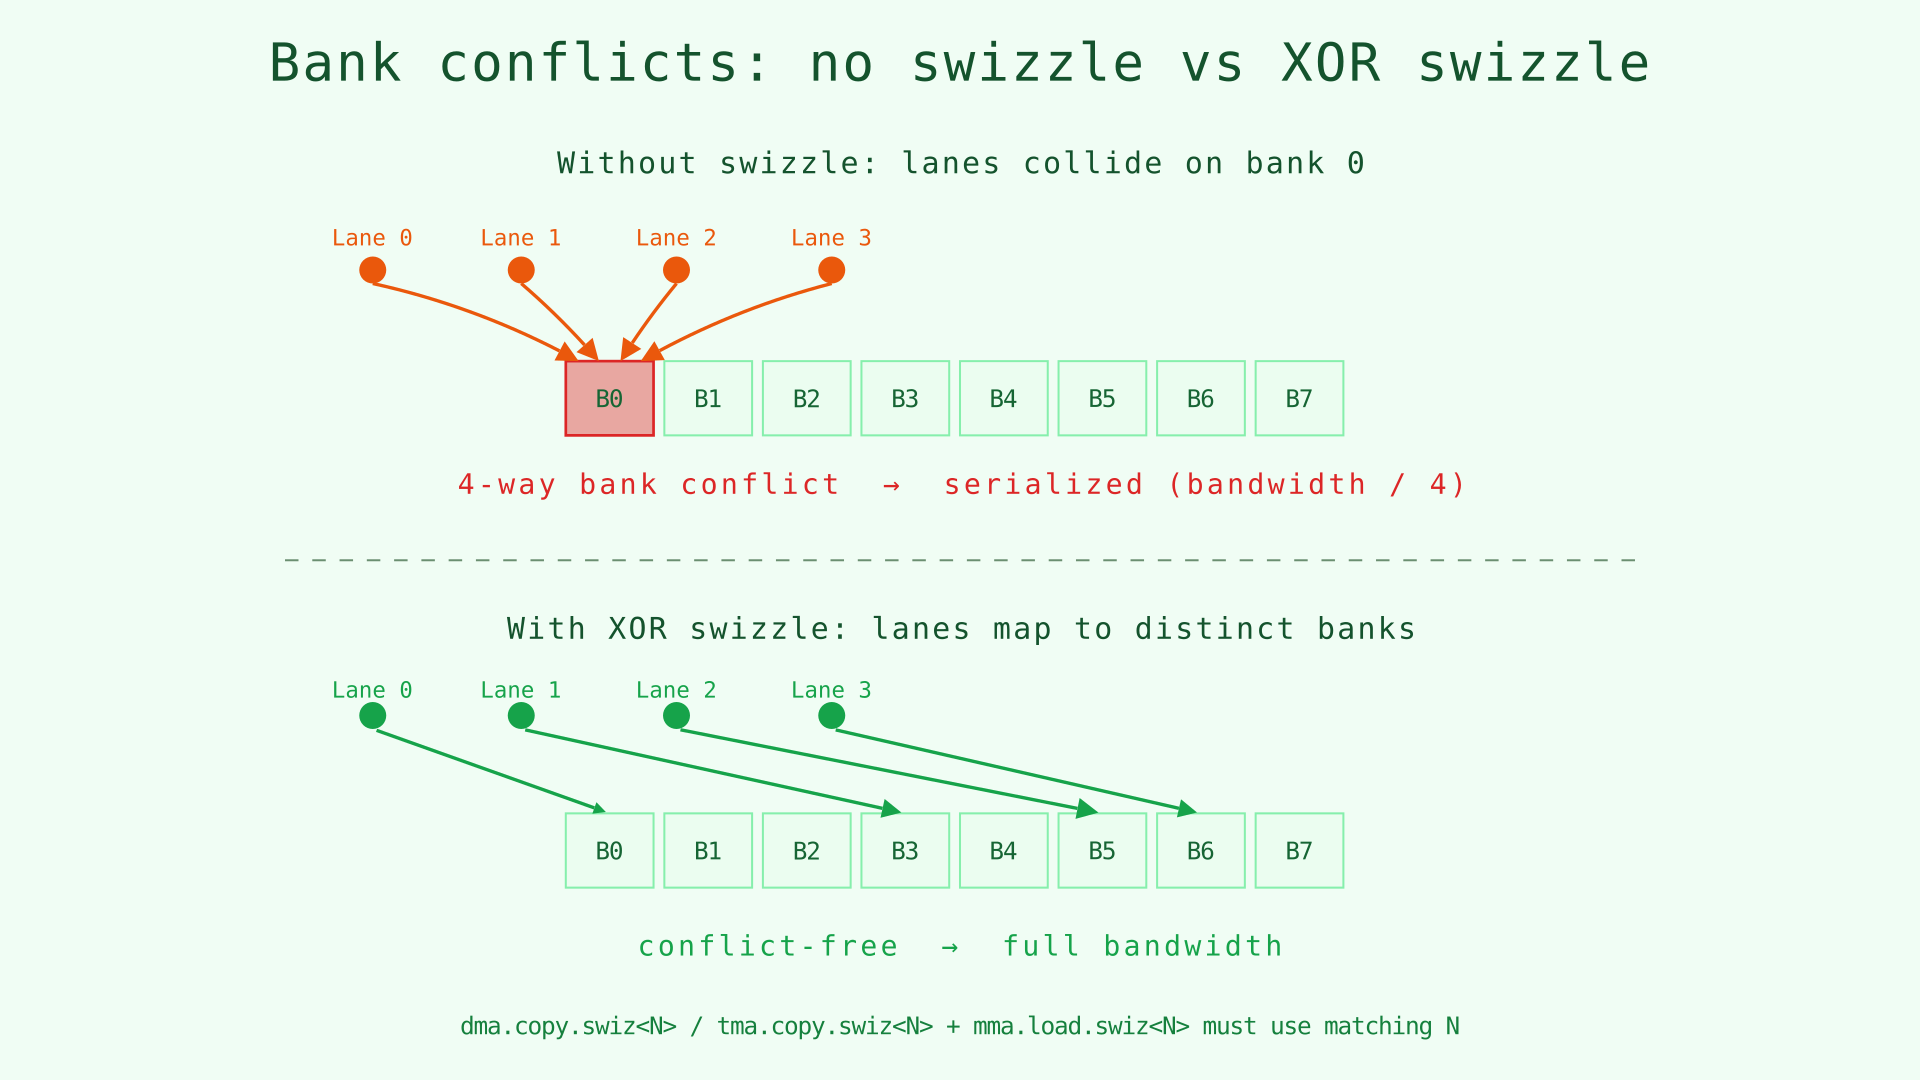
Shared memory 被条带化为 32 个 bank(每 bank 4 字节)。当同一 warp 中多条 lane 在同一周期访问映射到同一 bank 的不同地址时,硬件会串行化这些访问——即 bank conflict。稠密行优先 tile 常产生 2-way、4-way 或更严重的冲突,从而降低有效带宽。
Swizzle 对每行内的列索引施加固定的类 XOR 重映射,使访问分散到各 bank。鳄霸在 DMA 和 TMA 上均暴露该机制,语法相同、效果相同:
dma.copy.swiz<3> src => dst;       // 带 swizzle 的软件 DMA
tma.copy.swiz<3> src => dst;       // 带 swizzle 的硬件 TMA
拷贝按 swizzle 模式 N 将字节落入 shared memory。MMA 读取路径必须使用相同的 swiz<N>,以使地址与暂存布局匹配:
ma = mma.load.swiz<3> lhs_load_s.chunkat(_, iv_warp);Swizzle 并非 TMA 独有的特性。在鳄霸中,dma.copy.swiz<N> 与 tma.copy.swiz<N> 产生相同的 shared memory 布局。差异仅在于数据如何到达(线程协作 load 与描述符驱动的硬件传输),而非数据到达后如何排列。
Swizzle 级别。 模板参数设定粒度:swiz<0> 为恒等,随后 <1>、<2>、<3> 分别为 64B、128B、256B 的 XOR 模式。更大粒度可消除更宽的冲突模式,但要求 tile 范围与该粒度对齐。
匹配规则。 copy 上的 <N> 必须与 mma.load.swiz<N> 一致。若从 swiz<3> 的数据用普通 mma.load 读取,地址不一致,会得到错误结果。编译器不强制该配对——这是你需维护的正确性不变量。(如第 4 章所述,mma.load.swiz<N> 属于 MMA load 族。)
为何受限的接口反而有效:可表达范围 vs 性能
在原生 CUDA 中,程序员实现数据搬运时拥有巨大自由度:任意指针运算、可变步长访问、手动避免 bank 冲突、自定义 swizzle 公式。这种灵活性是双刃剑。可能的数据搬运模式空间巨大,但真正高性能的子集很窄——它要求合并的全局 load、无冲突的 shared memory 访问、正确的 swizzle 对齐。任何一项出错都会无声地将吞吐降低 2–32 倍。
鳄霸采取相反的策略:它将可表达的模式限制在确保落入性能甜区的范围内。当你写 dma.copy 或 tma.copy 时,编译器自动处理合并访存、无 bank 冲突的布局以及 swizzle 对齐。你不可能意外写出步长不合并的全局 load 或有 bank 冲突的 shared memory 布局——语法根本不允许。
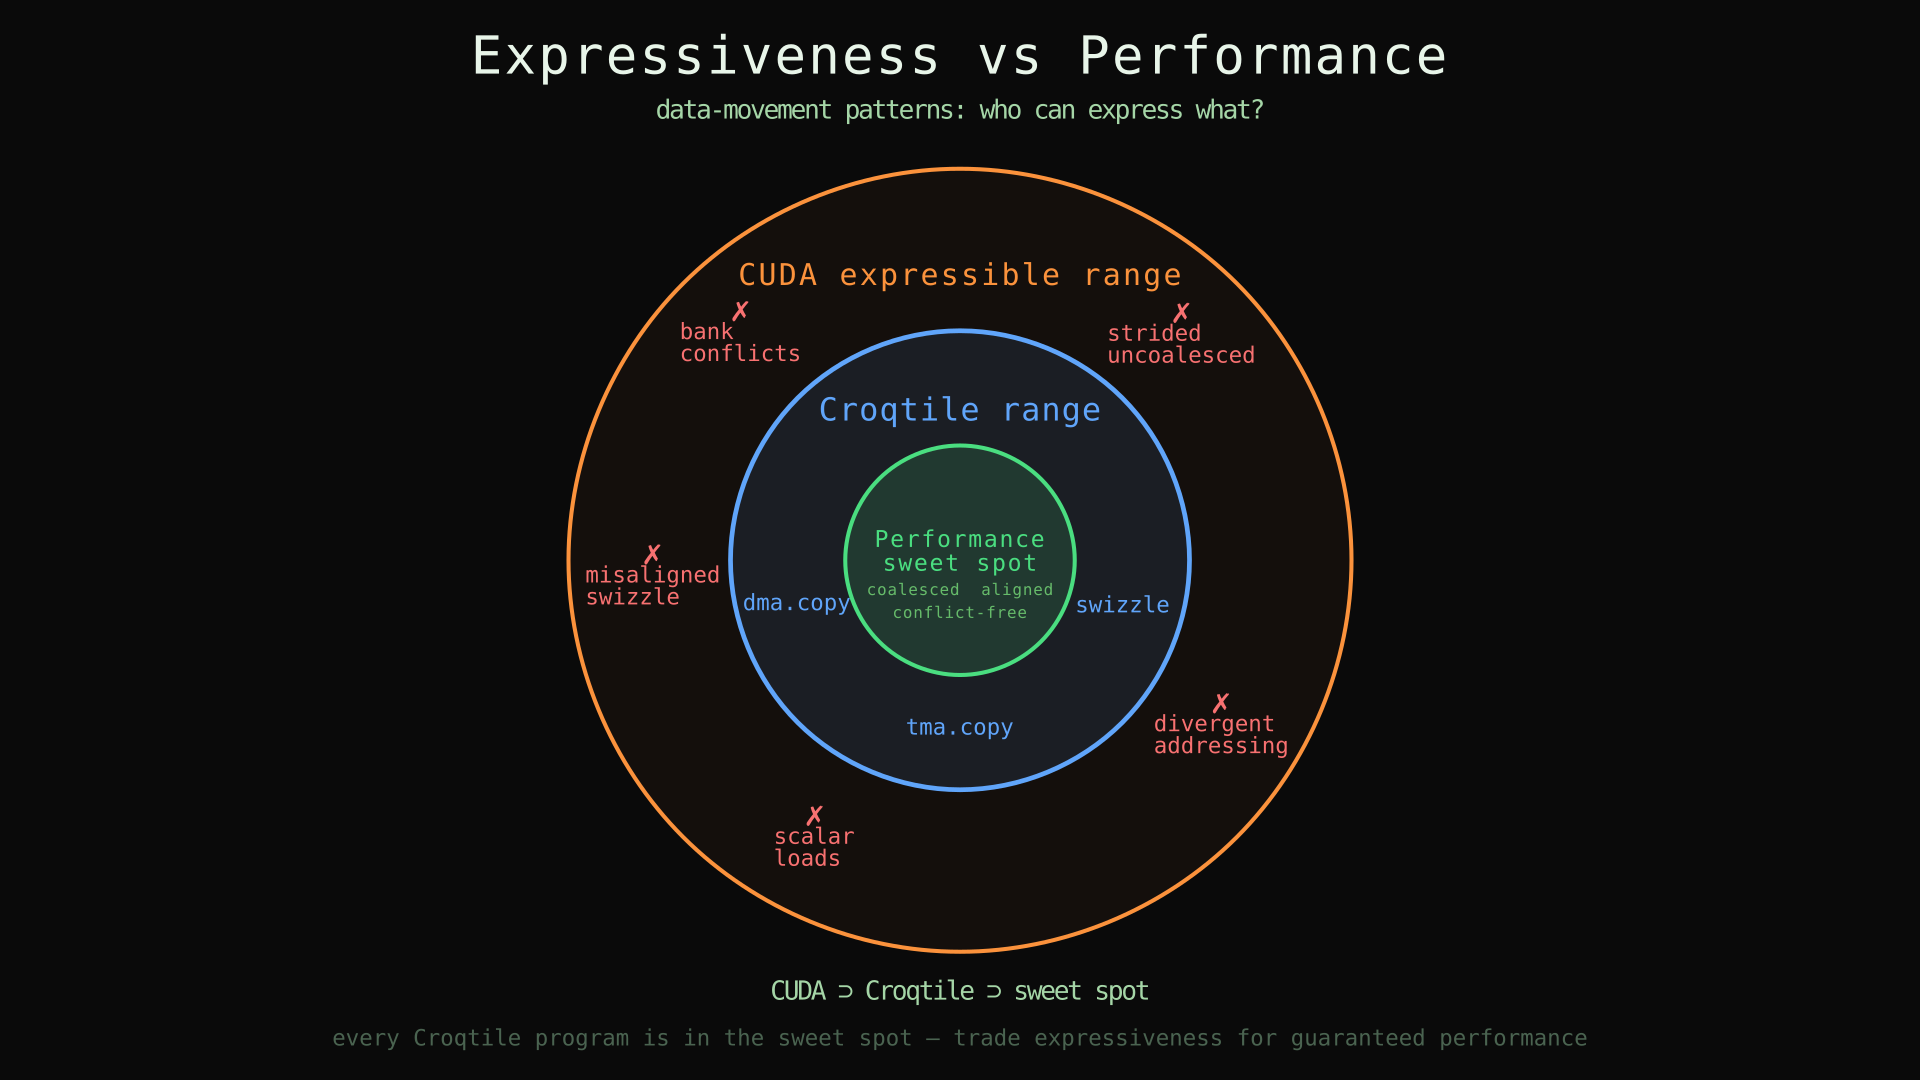
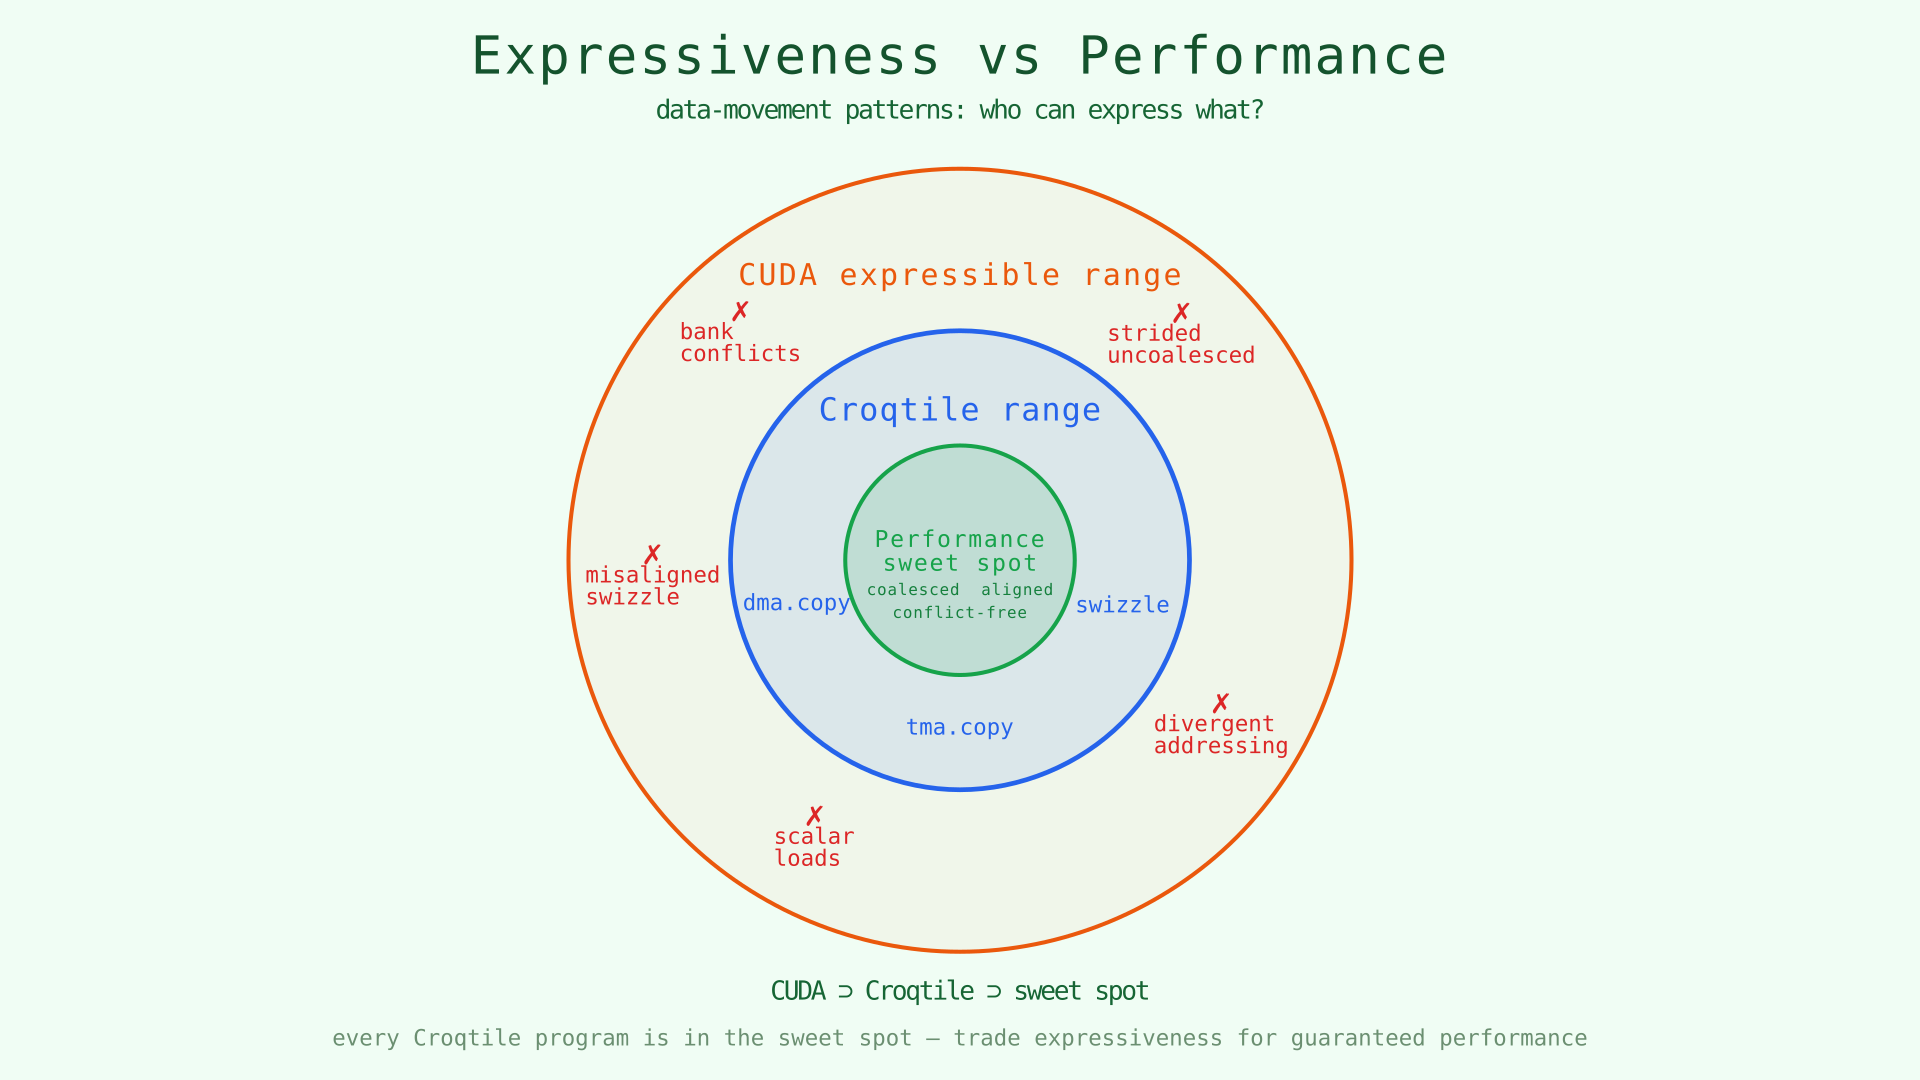
TMA 的描述符接口正是这一哲学的极端实例:它仅支持少数 tile 对齐的传输模式,但这些模式恰是硬件优化的对象。鳄霸的 dma.copy 遵循同一原则——它只生成合并且无冲突的模式,尽管底层的 LDG/STS 指令可以表达远多于此(包括许多慢模式)。这一权衡是显式的:你放弃编写任意数据搬运的能力,作为回报,你写的每一次数据搬运都是快的。
示例:流水线矩阵乘法中的 TMA
第 6 章的流水线骨架不变:stage 环、wait / trigger 事件、MMA commit,消费者在生产者填充下一槽时排空 tile。此处生产者将 dma.copy 换为 tma.copy.swiz<3>,消费者将 mma.load 换为 mma.load.swiz<3>:
__co__ void matmul(global f16 [M, K] lhs, global f16 [N, K] rhs, global f16 [M, N] output) {
  parallel {block_m, block_n} by [cdiv(M, MATMUL_WARP_M), cdiv(N, MATMUL_WARP_N)] : block {
    shared event full[MATMUL_STAGES], empty[MATMUL_STAGES];
    shared f16 [MATMUL_WARP_M, MATMUL_TILE_K] lhs_load_s[MATMUL_STAGES];
    shared f16 [MATMUL_WARP_N, MATMUL_TILE_K] rhs_load_s[MATMUL_STAGES];
    shared f16 [MATMUL_WARP_M, MATMUL_WARP_N] output_s;

    parallel p1 by 2 : group-4 {
      inthreads.async (p1 == 0) {
        foreach {iv_k} in [cdiv(K, MATMUL_TILE_K)] {
          stage = iv_k % MATMUL_STAGES;
          wait empty[stage];
          tma.copy.swiz<3> lhs.subspan(MATMUL_WARP_M, MATMUL_TILE_K).at(block_m, iv_k)
            => lhs_load_s[stage];
          tma.copy.swiz<3> rhs.subspan(MATMUL_WARP_N, MATMUL_TILE_K).at(block_n, iv_k)
            => rhs_load_s[stage];
          trigger full[stage];
        }
      }

      inthreads.async (p1 == 1) {
        mc = mma.fill.f16 0.0f;
        foreach {s} in [MATMUL_STAGES] { trigger empty[s]; }
        foreach {iv_k} in [cdiv(K, MATMUL_TILE_K)] {
          stage = iv_k % MATMUL_STAGES;
          wait full[stage];
          foreach {iv_warp} in [cdiv(MATMUL_TILE_K, MATMUL_WARP_K)] {
            ma = mma.load.swiz<3> lhs_load_s[stage].chunkat(_, iv_warp);
            mb = mma.load.swiz<3> rhs_load_s[stage].chunkat(_, iv_warp);
            mma.row.row mc, ma, mb;
          }
          mma.commit;
          trigger empty[stage];
        }
        mma.store mc, output_s;
        dma.copy output_s => output.subspan(MATMUL_WARP_M, MATMUL_WARP_N).at(block_m, block_n);
      }
    }
  }
}
与第 6 章的 dma.copy 版本相比,仅 ingress 与操作数 load 行发生变化;事件、staging 索引与 commit 保持不变。写回全局内存仍使用 dma.copy——按目标平台选择 TMA 或 DMA 进行 store。
处理不规则访问
前面介绍的 tiling 原语——chunkat、subspan(...).at(...)——假设张量可被均匀划分为 tile。对于教科书式 GEMM(M、N、K 均为 tile 尺寸的倍数)这足够了。但生产级 kernel 很少如此整齐。Expert 批次从动态偏移开始。卷积窗口相互重叠。最后一个 K-tile 几乎从来不是 TILE_K 的整数倍。有些输入以扁平 buffer 形式到达,需要重塑后 MMA 才能消费。
鳄霸为这些情况提供四种工具。每种工具都修改编译器解释张量寻址的方式,而不触碰流水线结构——DMA、TMA、MMA、事件、swizzle 全部照常工作。
任意偏移窗口:view 与 from
chunkat 将张量划分为大小相等的规则网格。但如果你需要的切片不从 tile 边界开始怎么办?考虑 mixture-of-experts(MoE)kernel:每个 expert 处理不同数量的 token,因此每个 expert 的操作数起始行在运行时确定。你无法预先计算固定的 tile 网格。
view(M, N).from(row, col) 定义从任意 (row, col) 起算的 M x N 矩形——不要求对齐:
patch = matrix.view(16, 16).from(37, 50);这是从第 37 行、第 50 列开始的 [16, 16] 切片。原点可为任意运行时值。
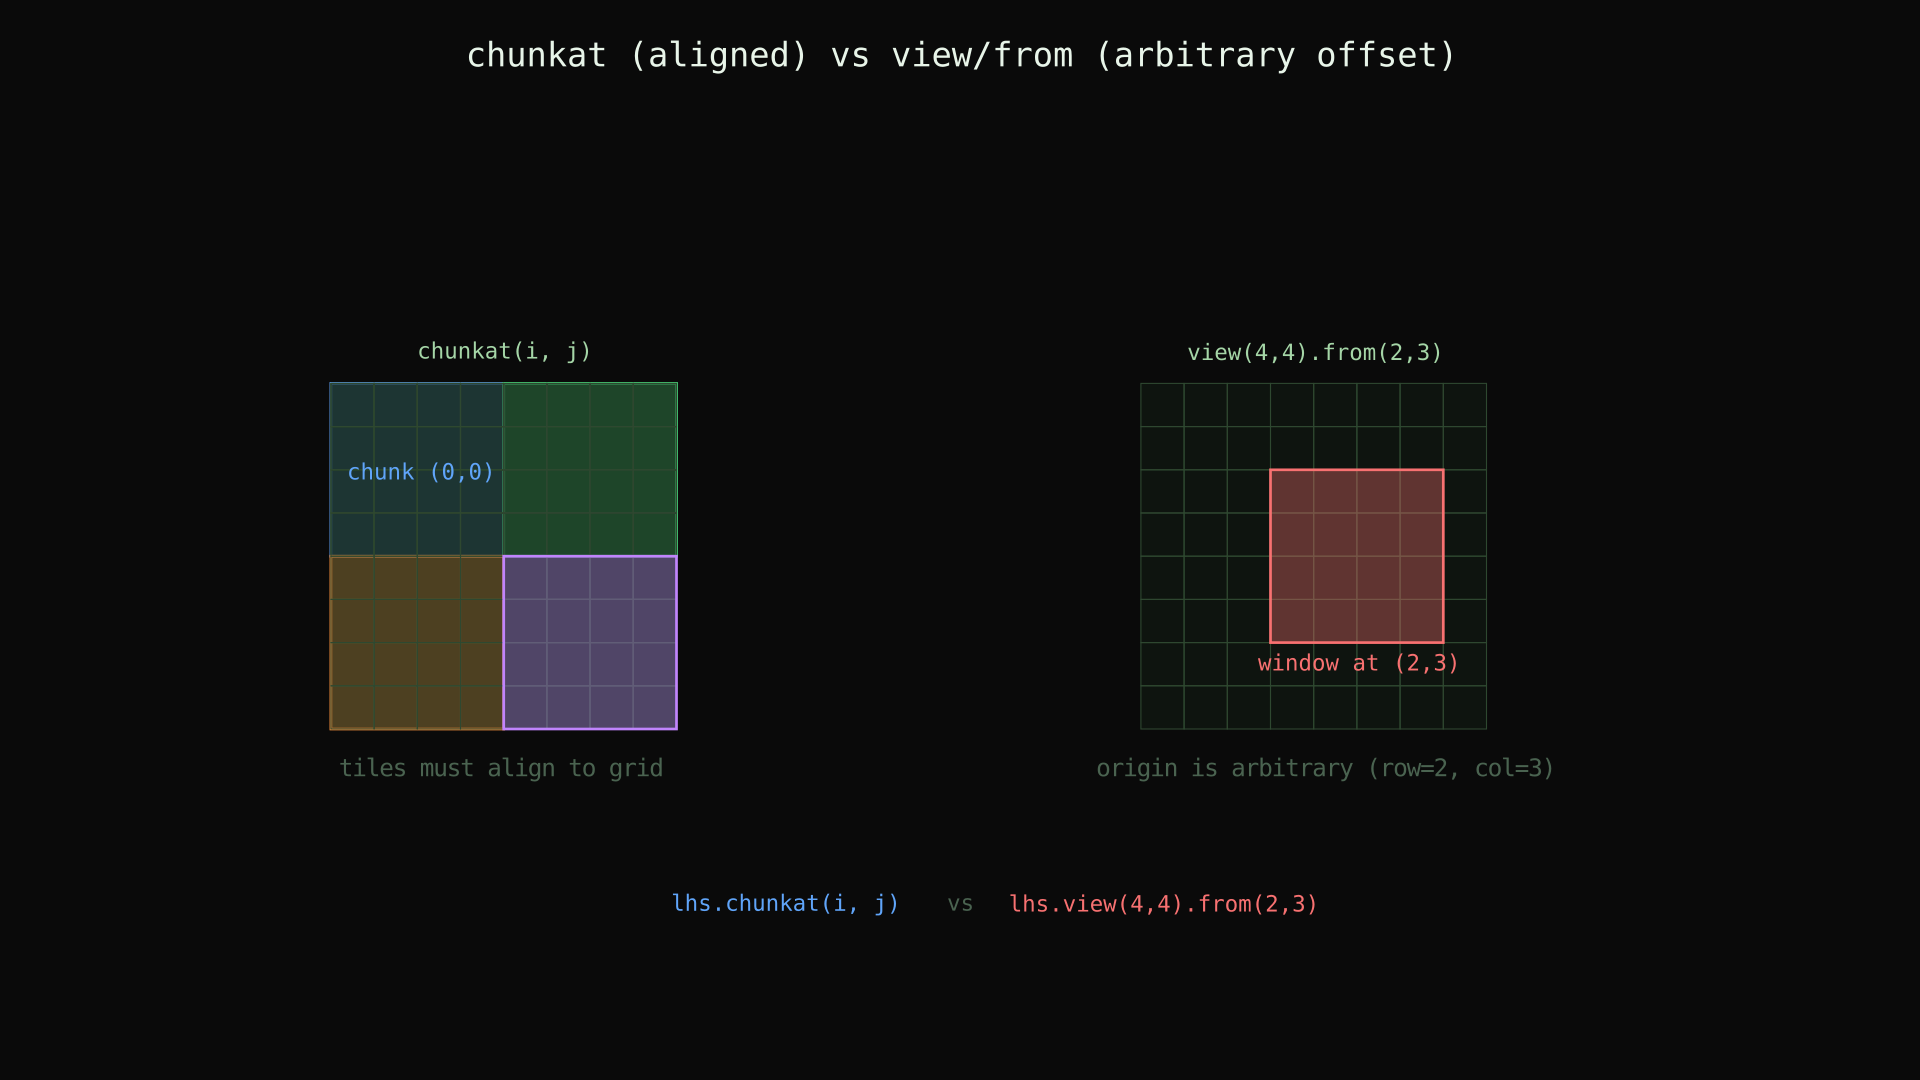
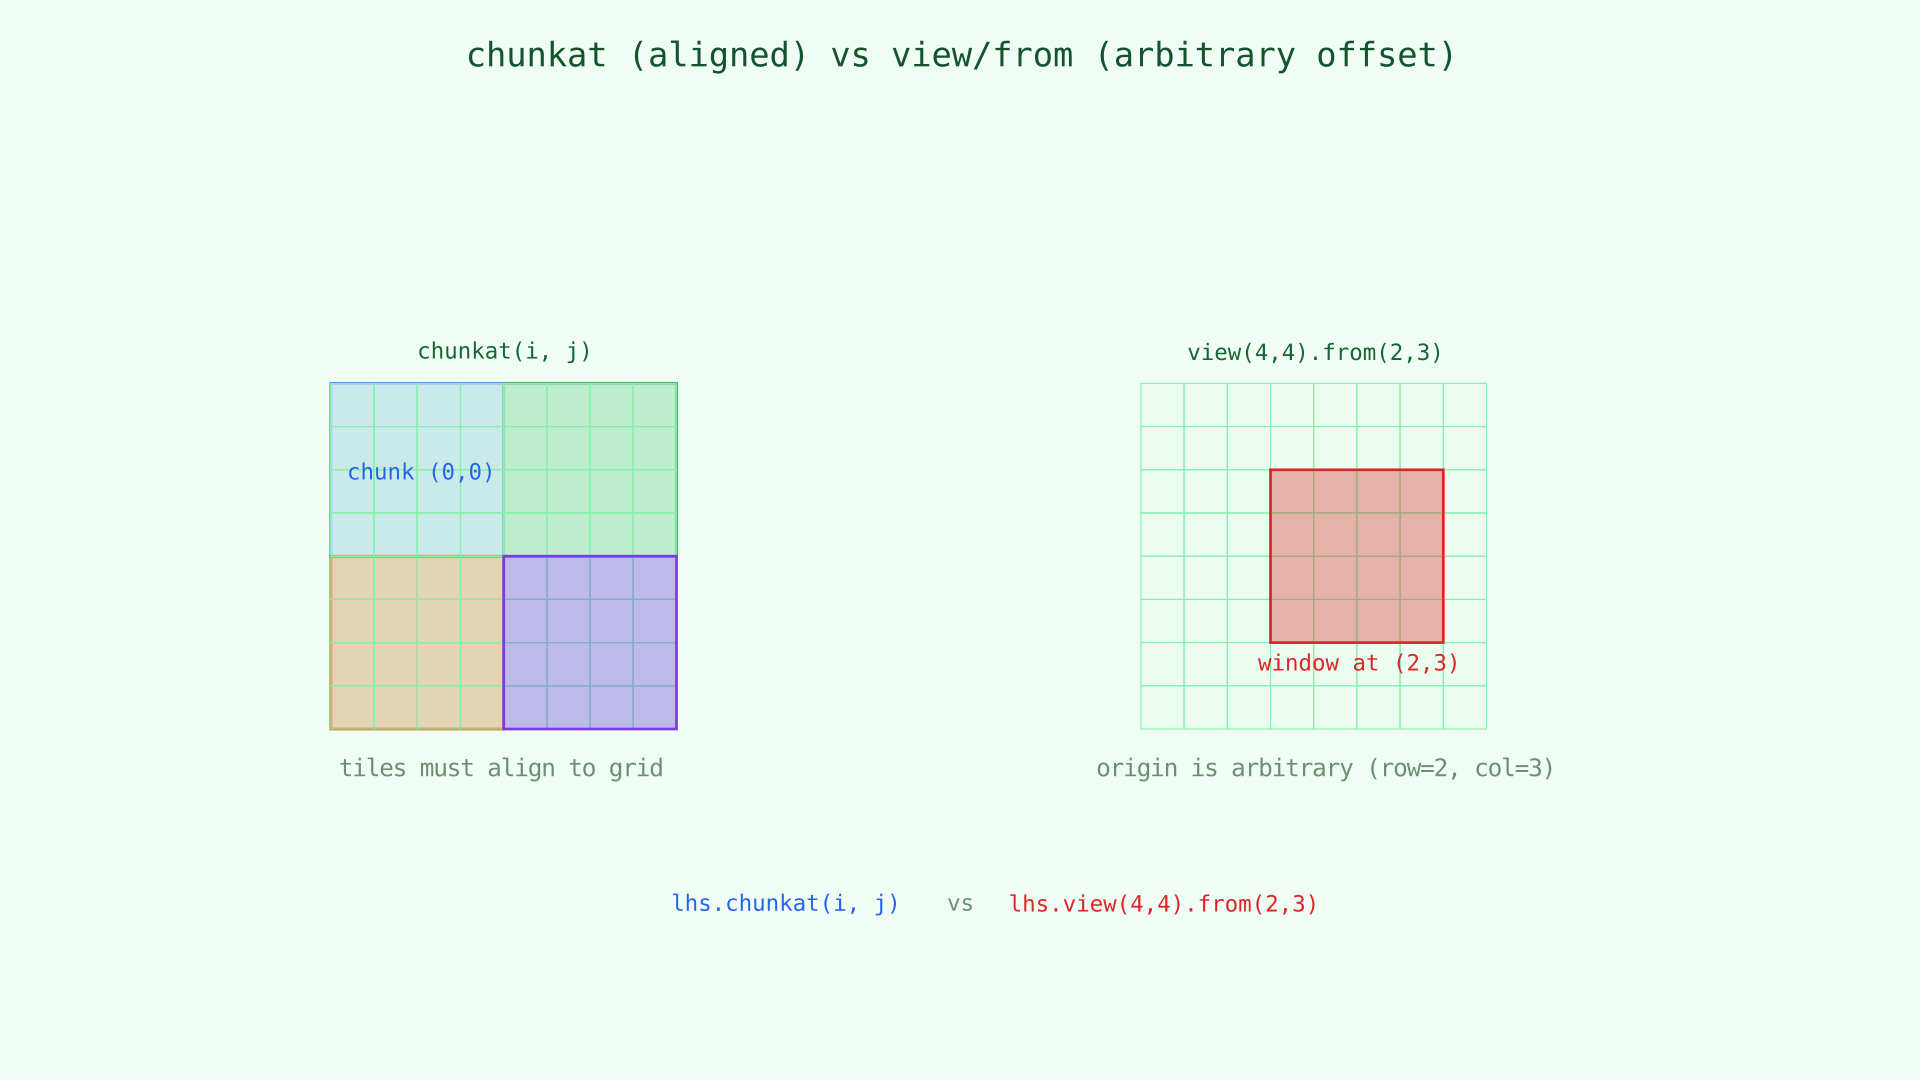
view / from 的威力在于可组合性:切出窗口后,所有下游操作——subspan、chunkat、dma.copy、tma.copy——都把该窗口当作独立张量来处理。流水线不变;只是原点移动了:
expert_lhs = lhs.view(expert_M, K).from(expert_offset, 0);
dma.copy expert_lhs.subspan(WARP_M, TILE_K).at(block_m, iv_k) => shared;
在 MoE 堆栈中,每个 expert 的 token 批次从动态行 expert_offset 开始。view / from 调用在流水线顶部重接操作数;之后的一切——DMA、staging、MMA 循环——对每个 expert 运行相同的代码。
何时使用。 当张量在编译期可被 tile 均匀划分时,优先用 chunkat。当窗口的原点或范围在运行时确定,或几何形状与 tile 网格不对齐时,用 view / from。
步长 tile:.subspan、.step 与 .at
subspan(M, K).at(i, j) 选取逻辑 tile 索引 (i, j) 处、范围为 [M, K] 的 tile。默认情况下 tile 紧密排列:tile (1, 0) 紧接在 tile (0, 0) 之后。但某些布局在 tile 之间留有间距——要么是行间有 padding,要么是 stencil kernel 需要重叠窗口。
添加 .step(sM, sK) 覆盖步长:tile 相隔 sM 行与 sK 列,而非紧密排列:
matrix.subspan(16, 16).step(32, 32).at(i, j);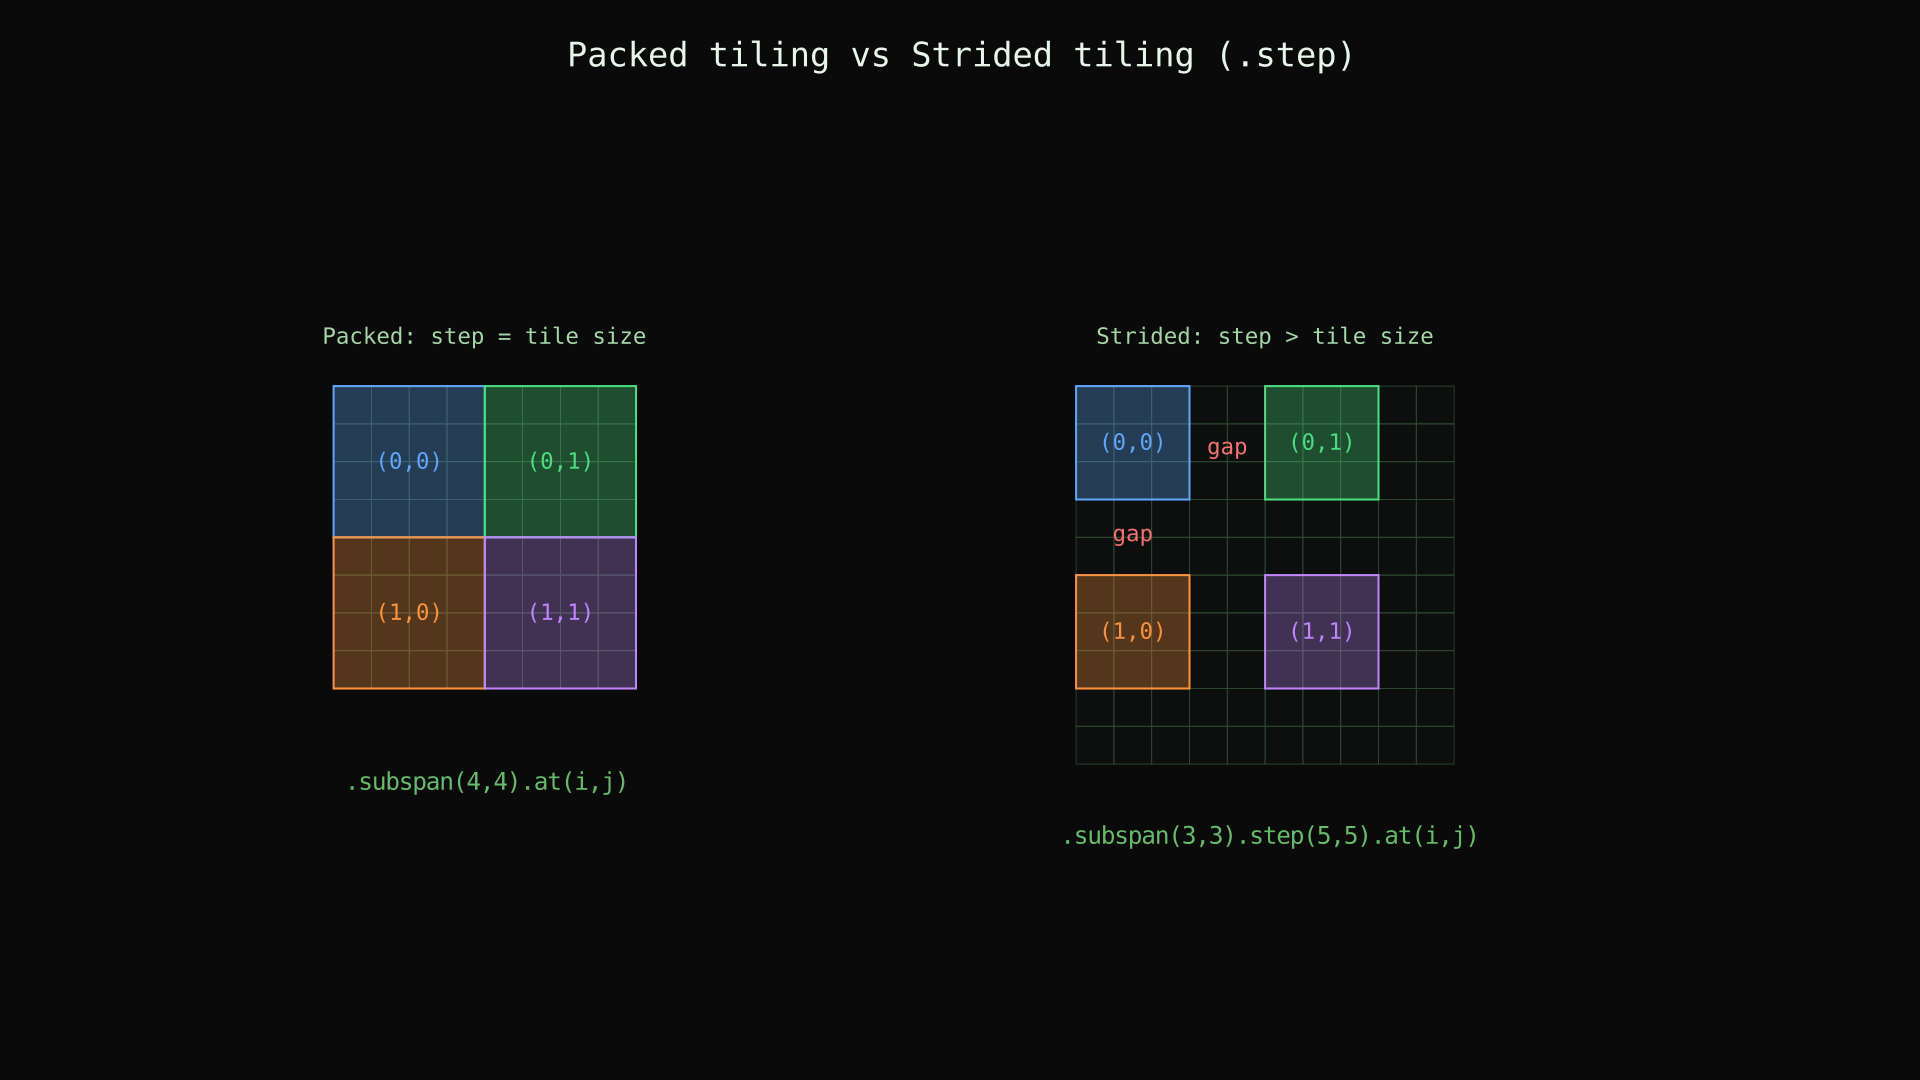
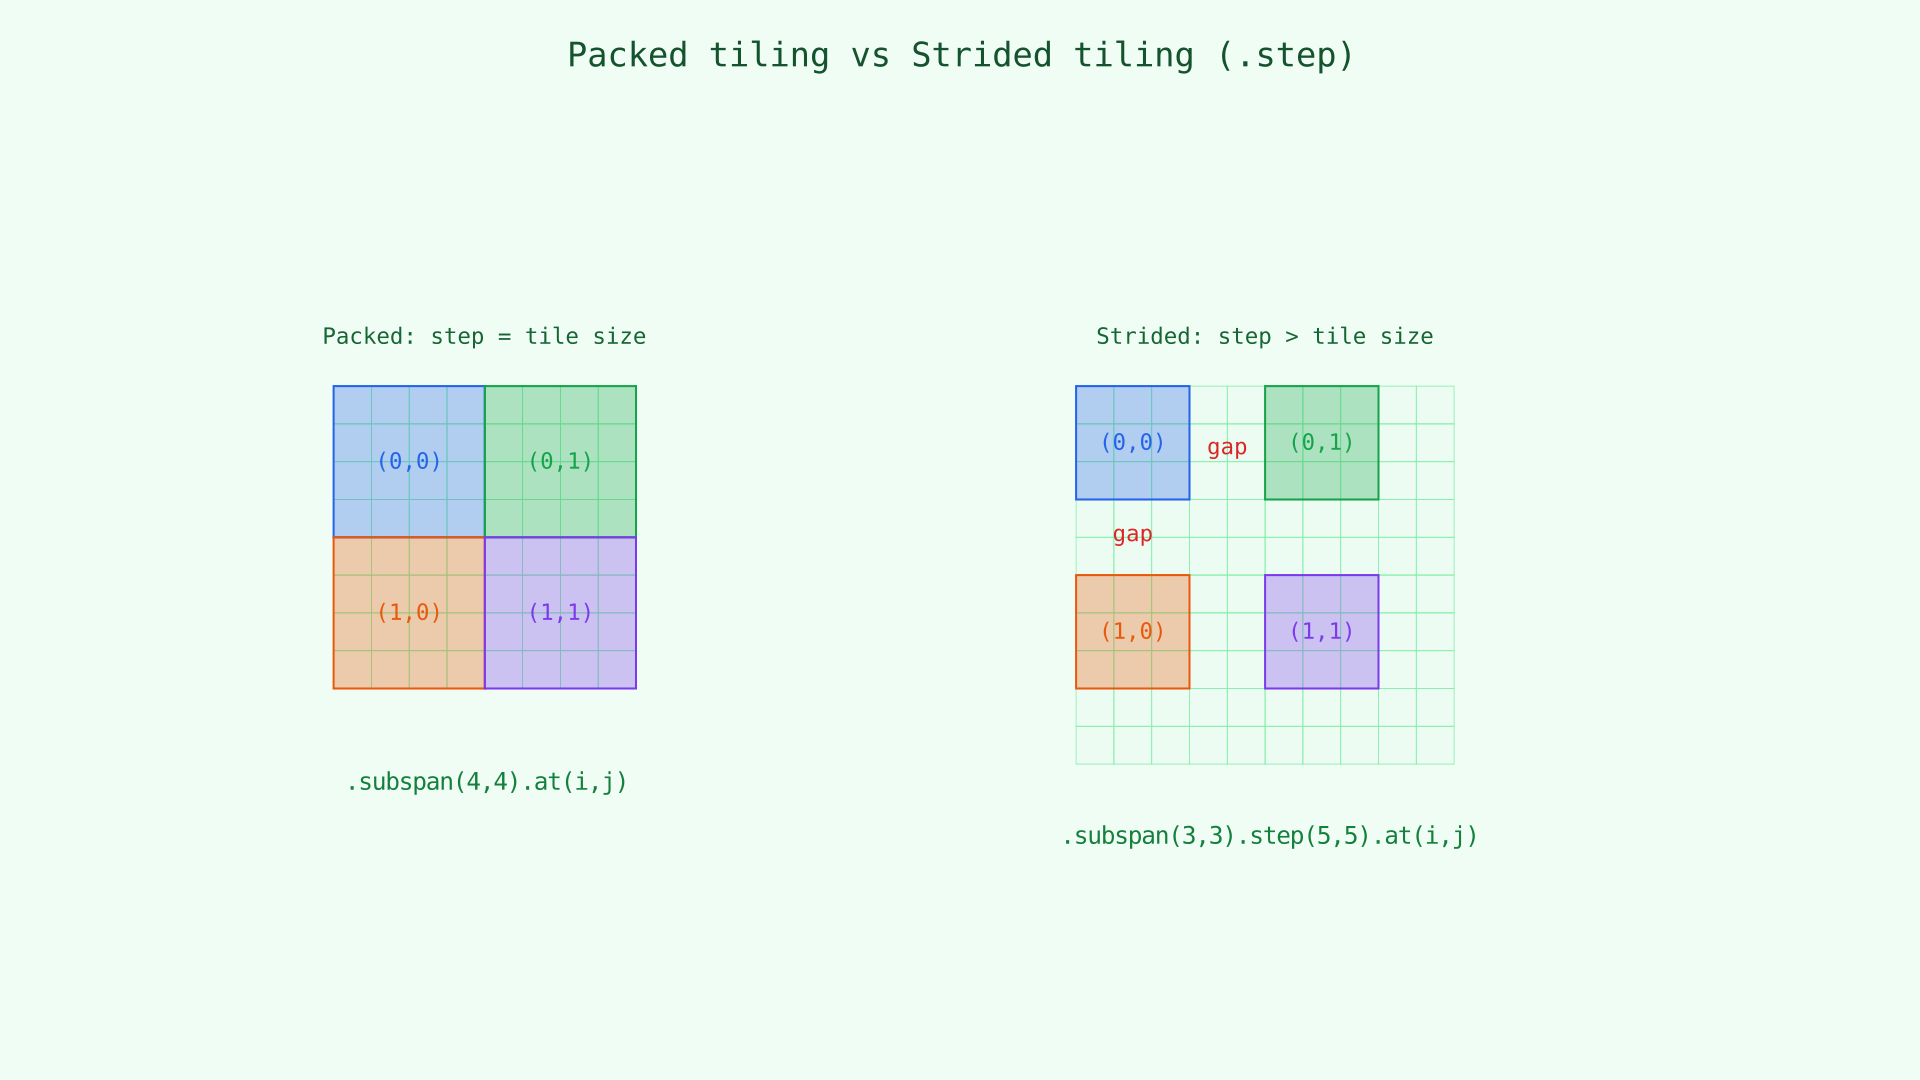
Tile (0,0) 从 (0,0) 开始,但 tile (1,0) 从第 32 行(而非第 16 行)开始,留出 16 行间隙。省略 .step 时步长等于 tile 尺寸——即紧密排列情形。
何时需要。 跳过行间 padding 或保护带。步长小于 tile 范围的重叠 stencil 窗口(如 16 x 16 tile 以 8 行为步进滑动)。匹配非稠密 tile-major 的外层内存布局——例如 tile 与元数据交错存放。
零填充:.zfill
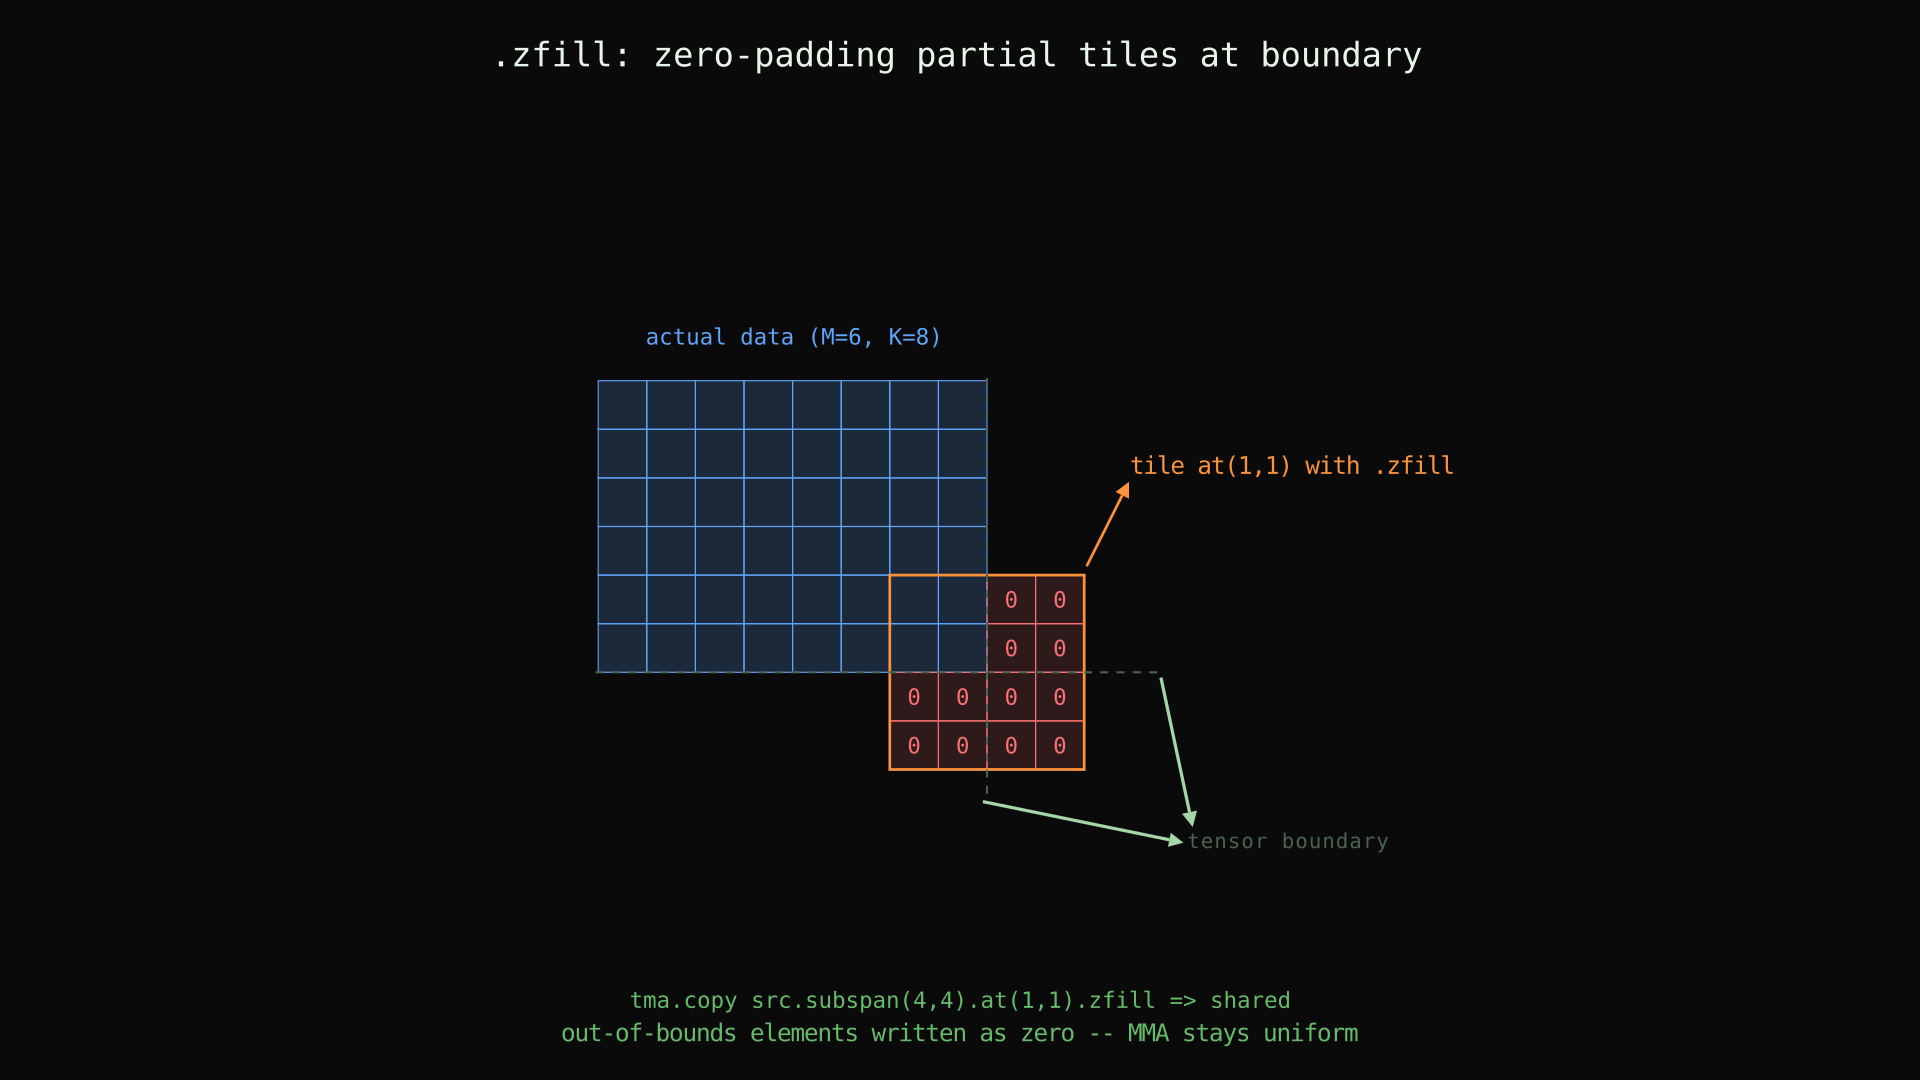
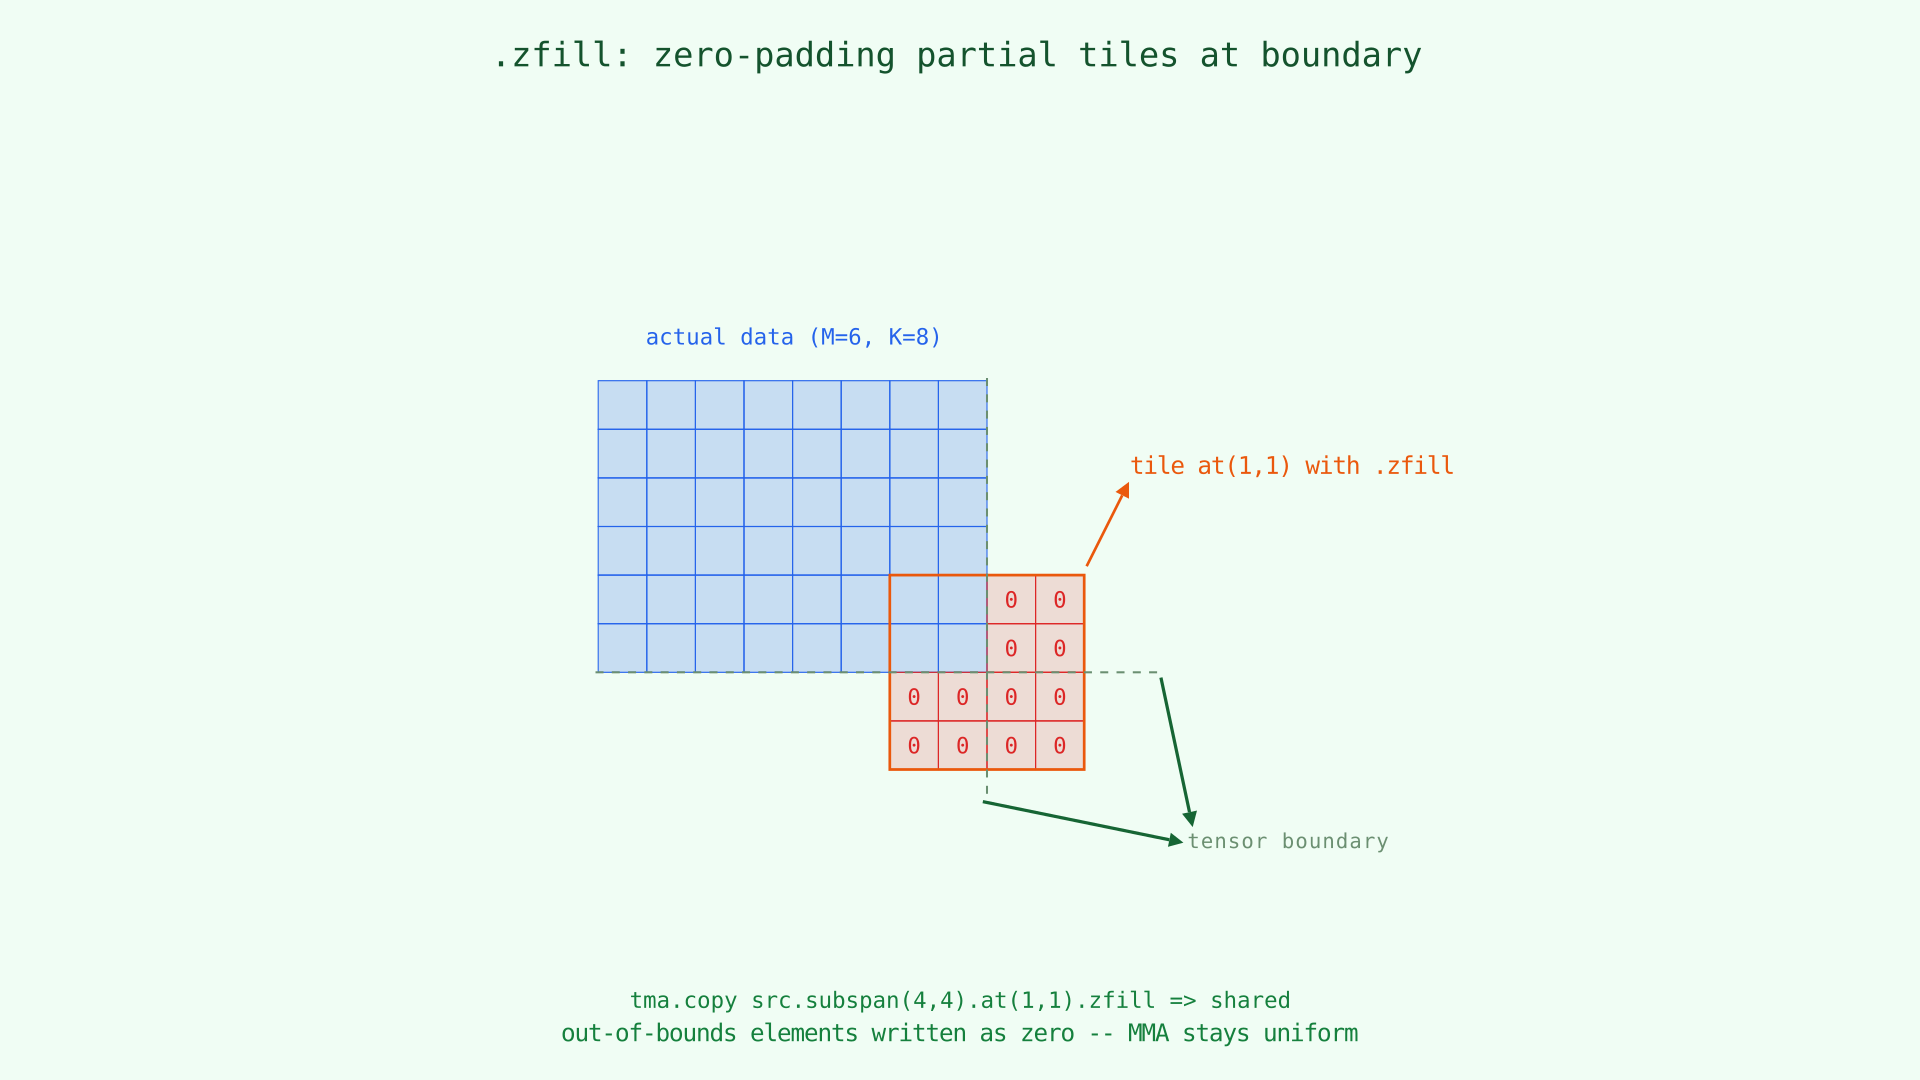
每个 tiled kernel 都面临同一边界情况:当 M 或 K 不是 tile 大小的整数倍时会怎样?沿该轴的最后一个 tile 是部分的——其中一些元素位于张量边界之外。在 GPU 上读取这些地址是未定义行为。
暴力修复是为边界 tile 增加特殊代码路径。但这破坏了 MMA 循环的均匀性,并添加了编译器无法优化掉的分支。.zfill 优雅地解决了这个问题:
tma.copy.swiz<3> lhs.subspan(WARP_M, TILE_K).at(block_m, iv_k).zfill
  => lhs_load_s;
.zfill 作用于 copy 的源侧:越界元素在目标 tile 中写为零。对于 GEMM,零对累加无贡献(0 × 任何值 = 0),因此 MMA 循环完全统一——内部 tile 与边界 tile 使用相同的代码——同时数学上仍然正确。无分支、无特殊情况、无性能惩罚。
布局重解释:span_as
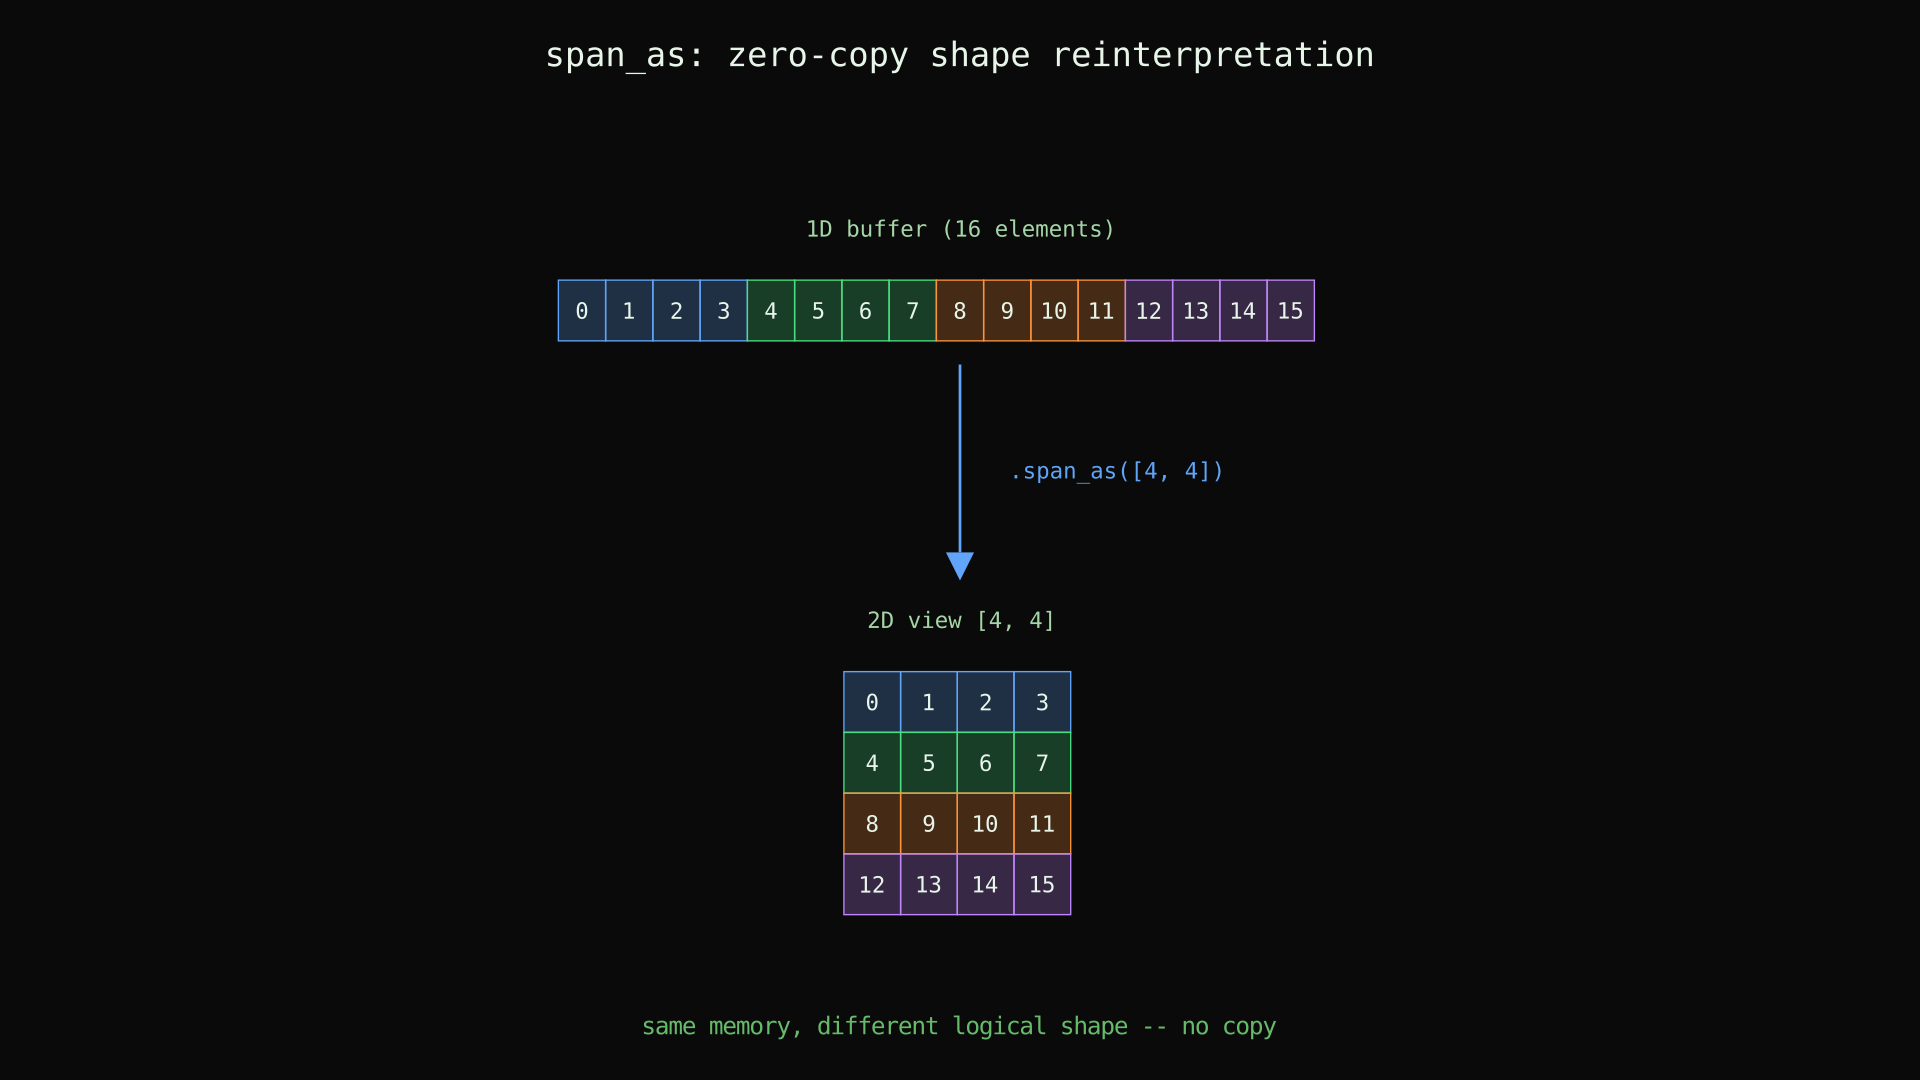
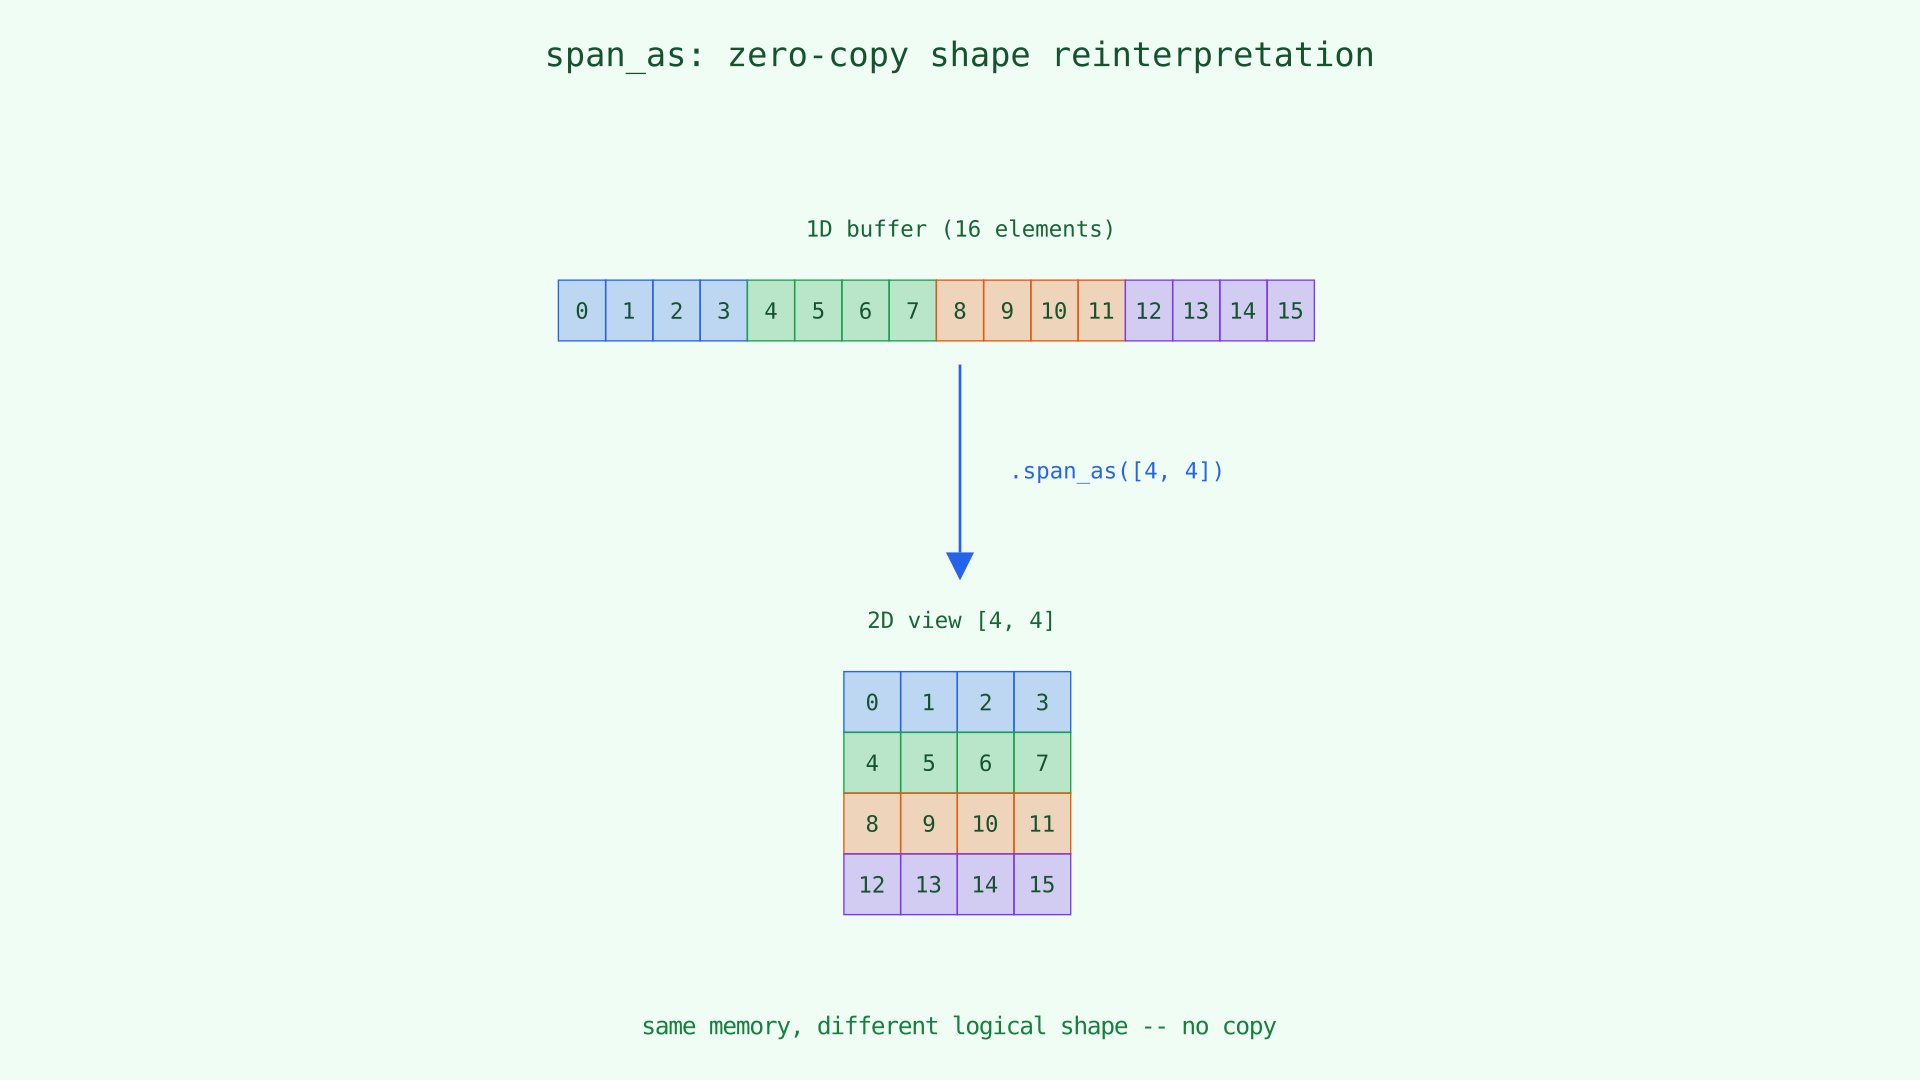
有些 kernel 将数据作为扁平一维条带载入,但需要将其作为二维矩阵喂给 MMA。朴素方法会将数据拷贝到一个重新形状的 buffer——浪费 shared memory 和带宽。span_as 通过就地重解释已有 buffer 的形状来避免这一问题:
flat_buffer.span_as([rows, cols])元素个数不变;仅逻辑秩改变。无数据移动。
strip_load = dma.copy data.chunkat(tile) => shared;
tile_2d = strip_load.data.span_as([tile_m, tile_k]);
ma = mma.load tile_2d.chunkat(_, iv_warp);
已载入的一维条带被暴露为二维矩阵供 chunkat 与 MMA 操作数 load 使用,无需额外拷贝或额外 shared memory。rows * cols 必须等于底层存储的 span 长度,否则编译器拒绝程序——该不变量在编译期检查,而非运行时。
本章小结
| 概念 | 语法 | 作用 |
|---|---|---|
| 软件 DMA(第 2、6 章) | dma.copy / dma.copy.swiz<N> |
线程协作的 tile 传输;可在任何 CUDA GPU 上运行 |
| 硬件 TMA | tma.copy / tma.copy.swiz<N> |
基于描述符的 Hopper 入站;专用引擎支持异步重叠 |
| Swizzle | .swiz<N>(copy)+ mma.load.swiz<N> |
无 bank 冲突的 SMEM 布局;DMA 与 TMA 效果相同 |
| 可表达范围权衡 | — | Croqtile 限制模式以确保合并、无冲突的传输 |
| 任意窗口 | view(M,N).from(r,c) |
参差不齐或由运行时定位的切片 |
| 步长 tiling | .subspan().step().at() |
非紧密布局、重叠 stencil |
| 部分 tile | .zfill |
越界元素零填充 |
| 形状重解释 | span_as([dims]) |
对 staging buffer 的零拷贝形状重塑 |
新语法
| 语法 | 含义 |
|---|---|
tma.copy src => dst |
TMA 硬件张量拷贝(Hopper SM90+) |
tma.copy.swiz<N> src => dst |
带 swizzle 模式 N(0–3)的 TMA 拷贝 |
dma.copy.swiz<N> src => dst |
带 swizzle 模式 N(0–3)的 DMA 拷贝;布局与 TMA 相同 |
mma.load.swiz<N> src |
与 swizzle N 一致的 MMA 操作数 load |
tensor.view(M, N).from(r, c) |
任意偏移的 M x N 窗口 |
.subspan(M, K).step(sM, sK).at(i, j) |
步长 tile 选取 |
.zfill |
在 copy 源侧对越界元素零填充 |
span_as([dims]) |
将线性存储重解释为带形状的张量 |
下一章从纯鳄霸迈向 C++ 互操作:__device__ 函数、寄存器提示、预处理器保护,以及需要贴近硬件时使用的内联 PTX。