Flash Attention:因果预填充 D=128
更新于 2026 年 9 月。目标硬件:NVIDIA H800 PCIe,SM90a,114 个 SM。 输入和输出为 BF16,使用 FP32 累加,采用 BSHD 布局。
本篇通过 Croqtile 逐步实现和优化因果预填充 attention 内核。 当前实现已不止于最初的三步演示:它使用操作 future、带代际的事件、独立的 QK 序言和 PV 收尾, 并加入持久化调度实验。较新的非持久化版本保留了同样的计算流水线,更适合学习其核心结构。
本页的内核和性能对照统一打包为可独立运行的 ZIP 和 tar.gz。 包内包含生成的 CUDA 和 runtime 头文件,因此运行示例需要 CUDA 和 CUTLASS,但不需要编译器仓库。 各对照实现所需的 Python 依赖见包内 README。
测试负载与源码导览
可下载的负载配置 定义了本次测量的三个尺寸:
| 参数 | 取值 |
|---|---|
| Batch、query 头数、KV 头数 | 4、32、32 |
| Query 和 KV 序列长度 | 二者均为 4096、8192 或 16384 |
| Head dimension | 128 |
| 模式 | 因果全序列前向计算,不含 dropout |
| 布局与精度 | [batch, sequence, head, dim],BF16 |
| 默认计时配置 | 50 次预热,200 次重复执行 |
主要讨论的尺寸是 B=4, H=32, S=8192, D=128。这些 prefill 负载的 Q/KV 长度相同,
且序列长度能被 128 整除。下文的优化内核并不意味着已支持任意尾块、GQA、不同的 Q/KV 长度或反向计算。
下表中的源码文件均位于下载包的 kernels/ 目录。版本编号标识实验,不代表必然的性能排序。
| 源码 | 在教程中的作用 |
|---|---|
| v1_manual_baseline.co | 顺序执行协作式 DMA、QK、softmax 和 PV |
| v2_manual_s2_1p2c_tma.co | 一个生产者、两个消费者,双缓冲 TMA 流水线 |
| v4_nonpersistent_fa.co | 当前的教学实现:逆序遍历、基于 future 的 QK/PV 重叠和 fragment 归约 |
| v3_fa3_overlap.co | 当前的持久化实现:主机构建任务列表,跨任务复用 Q 存储 |
建议先通过 v4 理解现代计算循环,再研究 v3 的任务调度。下载包包含四份 .co 源码、
对应的 CUDA、测试框架与配置,以及可执行的构建和测量脚本。下文的源码讲解均对应包内版本。
也可单独下载构建和测量脚本、
Python 对照测试框架及
v4 生成的 CUDA。
Online softmax:必须保持的不变量
对每个 query tile,维护当前的逐行最大值 m、分母 l 和未归一化的输出累加器 O。
处理每个 KV tile 时执行:
S = Q @ K^T
S[i,j] = -inf for masked positions
m_new = max(m, row_max(S))
alpha = exp2((m - m_new) * scale)
P = exp2(S * scale - m_new * scale)
l = alpha * l + row_sum(P)
O = alpha * O + P @ V
m = m_new

After all KV tiles: output = O / l
scale = log2(e) / sqrt(128) = approximately 0.12751743
源码中的 logsum 保存的是 l,即指数值之和,而不是该和的对数。
QK 和 PV 使用 FP32 累加;在 PV 的 tensor core 运算前,P 会转换为 BF16。
每个 CTA 只保留自己的 tile 和逐行状态,避免在全局内存中生成 S x S 的分数或概率矩阵。
不同 query CTA 仍会加载重叠的 K/V tile,因此缓存复用和任务顺序依然重要。
Online softmax 也允许逆序遍历 KV,但浮点舍入结果可能随运算顺序略有变化。
第 1 步:建立顺序执行基线
在 v1 中,一个 CTA 负责 128 个 query 行,两个各含 128 个线程的 warpgroup 分别计算 64 行。 Q 只复制一次;每次内层迭代先复制 K、计算 QK 和 softmax,再复制 V、计算 PV。 以下片段使用内核中已声明的视图和累加器:
q_s = dma.copy.swiz<128>
  Q_head.subspan(BLOCK_M, DIM).at(bm, 0) => shared;

// Inside the consumer's KV loop:
acc_s = mma.fill.f32 0.0f;
k_s = dma.copy.swiz<128>
  K_head.subspan(BLOCK_N, DIM).at(bn, 0) => shared;
mma.row.row acc_s, q_s.chunkat(wgm, _), k_s;

// Apply the causal mask and online-softmax update here.

v_s = dma.copy.swiz<128>
  V_head.subspan(BLOCK_N, DIM).at(bn, 0) => shared;
mma.row.col acc_o, acc_s_cast, v_s;
mma.row.row 直接从 shared memory 读取 Q 和 K 完成 QK。
PV 则通过 mma.row.col 使用 BF16 寄存器 fragment(acc_s_cast)和 shared memory 中的 V。
QK 的两个输入都在 shared memory 中,无需先用 mma.load 人工构造寄存器操作数。
数据流是串行的:load K -> QK -> softmax -> load V -> PV。下一步为数据搬运安排独立的执行路径。
第 2 步:让 TMA 加载与消费者计算重叠
v2 使用 128 x 128 的 tile,K 和 V 各有两个缓冲阶段,并设置三个 warpgroup: 一个生产者和两个消费者(1p2c)。每个消费者内部仍顺序执行 QK、softmax 和 PV, 而生产者提前填充后续 tile。
当前写法应使用 tma.load 表达 global-to-shared 搬运,并把完成信号绑定到事件。
下面的生产者片段采用 v4 的变量名和逻辑,从对角线向第零块逆序遍历 K/V:
shared event qf;
shared event kf[K_STAGES], vf[V_STAGES];
shared event ke[K_STAGES] = ready, ve[V_STAGES] = ready;

// Inside inthreads.async (p == 0):
q_load = tma.load.async.evict_first.swiz<SWIZ>
  Q_head.subspan(BLOCK_M, DIM).at(bm, 0) => q_shared;
trigger qf after q_load;

mutable u32 k_pipe_order = 0;
mutable u32 v_pipe_order = 0;
foreach {issue} in [kv_bound] {
  bn = bm - issue;
  k_slot = k_pipe_order % K_STAGES;
  v_slot = v_pipe_order % V_STAGES;

  wait ke.at(k_pipe_order);
  k_load = tma.load.async.evict_last.swiz<SWIZ>
    K_head.subspan(BLOCK_N, DIM).at(bn, 0) => k_buf[k_slot];
  trigger kf.at(k_pipe_order++) after k_load;

  wait ve.at(v_pipe_order);
  v_load = tma.load.async.evict_last.swiz<SWIZ>
    V_head.subspan(BLOCK_N, DIM).at(bn, 0) => v_buf[v_slot];
  trigger vf.at(v_pipe_order++) after v_load;
}
两个消费者等待 kf/vf 就绪后读取 shared buffer,并在对应计算完成后释放 ke/ve。
= ready 提供初始的空槽令牌,不要再手动触发一次初始代际。
这里有三个关键点:
trigger kf.at(order) after k_load绑定 TMA 完成事件,不会阻塞生产者。 如果发出加载后立即使用普通trigger,就会过早发布就绪信号。kf.at(order)选择槽位order % K_STAGES和代际order / K_STAGES。 只有数据索引才使用k_buf[slot];把order % K_STAGES传给事件会丢失代际信息。- 事件表达就绪条件和参与者,硬件 barrier 及 TMA 事务计数由编译器选择。 事件不是源码层面的 named-barrier ID。
包内 v2 已使用 future 和 .at(bn),但保留了 tma.copy.async 的加载写法及手动初始化空槽令牌。
新代码应优先采用上面带方向、使用 ready 初始化的形式;shared-to-global 输出仍使用 tma.copy。
包内 v2 先把两个消费者的输出 fragment 写入同一个 shared output tile,再使用
tma.copy o_buf => O_head.subspan(BLOCK_M, DIM).at(bm, 0) 写回完整 tile。
旧的逐消费者 TMA 输出形式会产生重叠写入,未通过当前正确性检查;本次测量的 v2 已包含此修复。
第 3 步:通过操作 future 让 softmax 与 PV 重叠
当前 v4 循环显式表达了依赖关系:先执行仅含 QK 的序言,在稳态循环中发出当前 tile 的 QK 和前一个 tile 的 PV,最后用一次 PV 收尾。第零次迭代不再执行概率全为零的占位 PV。
逆序遍历把因果掩码集中到序言
非持久化网格在每个 head 内逆序排列 query tile:
parallel.async {tile, head, batch}
    by [cdiv(Q_SEQ, BLOCK_M), H, B] : block {
  bm = cdiv(Q_SEQ, BLOCK_M) - 1 - tile;
  // The complete kernel declares views, buffers, and thread scopes here.
}
对于 query tile bm,KV 的处理顺序是 bm, bm-1, ..., 0。
当 Q/KV 长度相同且 BLOCK_M = BLOCK_N = 128 时,只有第一个 tile 与因果对角线相交。
其局部掩码为:
apply {i, j} in acc_s.span {
  if (j > cid * WG_M + i)
    acc_s.at(i, j) = -inf;
}
剩余的 bm 次迭代无需逐元素检查因果条件。先提交工作量较大的 query tile,
也会改变网格最后一波 CTA 的工作量:较短的 CTA 被安排在后面。
这是一种需要实测的调度选择,并不保证 CUDA block 的实际执行顺序。
序言等待 Q 和第一个 K tile,计算 QK 并应用掩码,然后初始化逐行最大值、分母和 BF16 概率。
此后才初始化 acc_o,以缩短输出累加器的活跃区间。
消费者的稳态循环
下面是 v4 的稳态循环。K 和 V 使用独立的逻辑序号,因为 QK 读取当前 K tile, 而 PV 仍在使用前一个 V tile:
foreach {step} in [kv_bound - 1] {
  k_slot = k_pipe_order % K_STAGES;
  prev_v_slot = v_pipe_order % V_STAGES;

  acc_s = mma.fill.f32 0.0f;
  wait kf.at(k_pipe_order);
  qk = mma.row.row.async acc_s,
    q_shared.subspan(WG_M, DIM).at(cid, 0), k_buf[k_slot];

  wait vf.at(v_pipe_order);
  pv = mma.row.col.async acc_o, acc_s_cast, v_buf[prev_v_slot];

  wait qk;
  trigger ke.at(k_pipe_order++);

  copy(scores_max_prev, scores_max);
  reduce_max(scores_max, acc_s, 1);
  apply {i} in scores_max.span {
    scores_max.at(i) = __max(scores_max.at(i), scores_max_prev.at(i));
    scores_scale.at(i) = __exp2f(
      scores_max_prev.at(i) * 0.12751743f -
      scores_max.at(i) * 0.12751743f);
  }
  apply {i} in logsum.span
    logsum.at(i) = logsum.at(i) * scores_scale.at(i);
  apply {i, j} in acc_s.span
    acc_s.at(i, j) = __exp2f(
      acc_s.at(i, j) * 0.12751743f - scores_max.at(i) * 0.12751743f);
  apply {i} in scores_sum.span
    scores_sum.at(i) = 0.0f;
  apply {i, j} in acc_s.span
    scores_sum.at(i) = scores_sum.at(i) + acc_s.at(i, j);
  apply {i} in logsum.span
    logsum.at(i) = logsum.at(i) + scores_sum.at(i);

  wait pv;
  trigger ve.at(v_pipe_order++);

  apply {i, j} in acc_s_cast.span
    acc_s_cast.at(i, j) = __to<bf16>(acc_s.at(i, j));
  apply {i, j} in acc_o.span
    acc_o.at(i, j) = acc_o.at(i, j) * scores_scale.at(i);
}
wait qk 使 acc_s 可用,此时独立的 PV 操作仍可能尚未完成,中间的 softmax 工作使用标量指令。
必须在 wait pv 之后,才能重新缩放 acc_o 或覆盖 PV 正在读取的概率 fragment。
编译器根据这些 future 依赖推导 WGMMA commit group 和等待深度。
Prologue:  QK[0] -> mask + softmax[0] -> P[0]

Steady:    issue QK[n] -> issue PV[n-1] -> wait qk
                                           |
                              softmax[n] while PV may run
                                           |
                              wait pv -> rescale O, write P[n]

Epilogue:  issue PV[last] -> finalize denominator -> wait final_pv -> store
QK 和 PV 是排队执行的 tensor core 操作;这个调度不要求二者在不同 tensor core 上同时执行。 真正有用的重叠是:PV 尚未完成时执行标量 softmax 工作。 实际能获得多少重叠,需要结合生成代码和 profiling 判断。
推迟分母的跨 lane 归约
在 v4 中,apply {i, j} 把各 lane 持有的分数元素累加到该 lane 的局部行和。
分母在整个 KV 循环中保留这些部分和。由于同一行的各 lane 使用相同的缩放因子,
跨 lane 求和可以推迟到循环结束:
final_v_slot = v_pipe_order % V_STAGES;
wait vf.at(v_pipe_order);
final_pv = mma.row.col.async acc_o, acc_s_cast, v_buf[final_v_slot];
all_reduce_sum(logsum);
apply {i} in scores_scale.span
  scores_scale.at(i) = 1.0f / logsum.at(i);
wait final_pv;
trigger ve.at(v_pipe_order++);

apply {i, j} in acc_o.span
  acc_o.at(i, j) = acc_o.at(i, j) * scores_scale.at(i);
mma.store acc_o, o_buf.subspan(WG_M, DIM).at(cid, 0);
tma.copy o_buf => O_head.subspan(BLOCK_M, DIM).at(bm, 0);
最终 PV 尚未完成时,all_reduce_sum 完成并广播逐行分母。
逐行最大值仍需在每个 tile 上归约;若把局部求和替换成 reduce_sum,就会改变这一调度。
持久化 v3 使用两个与数据布局相关的 CUDA device helper 实现局部行和与最终归约; v4 则通过 fragment 操作表达。因此,不能说当前完整 v3 不需要手写 device code, 也不能说连同调度在内只有 80 行。
第 4 步:持久化调度与跨任务生命周期
当前 v3 启动 PERSISTENT_CTAS = 114 个 CTA,并为每个 CTA 分配一份 query tile 任务列表。
一个 tile 的因果计算量随 bm + 1 增加,所以让各 CTA 处理相同数量的 tile 并不能平衡工作量。
主机调度器采用以下成本估计:
estimated_cost(bm) = 2 * (bm + 1) + fixed_cost
fixed_cost = 4 by default, configurable with CHOREO_SCHED_FIXED_COST
系数二对应 QK/PV 这一对运算。调度器以成对的 batch/head 条目为单位,按 query tile 的降序考虑任务, 分配给当前估计负载最小的分桶;之后在保持配对关系的前提下重新平衡,缩小最重与最轻分桶的估计差距, 再在每个分桶内按 batch/head 稳定排序,以保留 K/V 局部性。 这是基于成本估计的静态分配,不是设备侧的 work-stealing 队列。
任务数组按负载尺寸缓存在主机上,并复制到设备。预热后的内核计时不包含首次构建和上传任务列表的开销; 如果应用会频繁改变请求尺寸,应单独报告这部分初始化成本。
Q buffer 需要独立的交接协议
K 和 V 已有 empty/full 环形缓冲,但 Q 只有一个跨任务复用的 shared 槽位。 当前 v3 用标量事件表达其生命周期:
shared event qf;
shared event qe = ready;

// Producer, once per task:
wait qe;
q_load = tma.load.async.evict_first.swiz<SWIZ>
  Q_head.subspan(BLOCK_M, DIM).at(logical_bm, 0) => q_shared;
trigger qf after q_load;

// Consumers, before the task's first QK:
wait qf;

// Consumers, after the last QK has finished using Q:
trigger qe;
消费者完成当前任务的最终 PV 和输出时,生产者就可以加载下一个任务的 Q。 K/V 的逻辑序号在任务循环外初始化,并跨任务持续递增;重置它们会破坏环形缓冲的代际关系。 softmax 状态和累加器则要为每个 query tile 重新初始化。
生产者的 Q-empty 等待由两个参与的 warp(p == 0 && t < 64)共同执行;
在该范围内,warp 0 发出 K 加载,warp 1 发出 V 加载。
不能因为 TMA 由单个 lane 发出,就把 Q 的交接缩小到单个 lane:
编译器依据实际参与 wait/trigger 的线程选择 barrier lowering。
满足条件的单槽 ready 事件可以降为 named barrier,而 TMA 完成和多阶段环使用相应的 mbarrier 路径。
当前源码把任务编码为 bm | (head << 8) | (batch << 14),因此 bm 限于 8 位,head 限于 6 位。
再加上固定的 114-CTA 网格及 Q/KV 等长的因果假设,v3 是针对这组负载调优的特化实现。
移植到其他负载时必须重新检查这些限制。
资源分配也是调度的一部分
对于 128 x 128 的 BF16 tile,Q 和 O 各占 32 KiB,两个 K tile 和两个 V tile 共占 128 KiB,
每个 CTA 的数据缓冲合计 192 KiB。因此增加缓冲阶段数会显著改变资源需求。
当前 v3/v4 的生产者通过 setreg_dec 请求每线程 40 个寄存器,消费者通过 setreg_inc 请求 232 个;
v2 使用 24/240。这些是寄存器分配控制值,不是实测的寄存器占用数。
[[launch_bounds(_, 1)]] 提供编译器做寄存器预算时使用的最少常驻 block 数目标,
并不强制每个 SM 最多只能常驻一个 CTA。实际常驻数量由线程、寄存器和 shared memory 资源共同决定。
同样,parallel.async 表达异步发起,并不表示请求 cluster 协作或 multicast。
性能测量
以下数据均于 2026 年 9 月 21 日使用下载包中的对应源码重新测量,已替换旧性能表,不混用历史样本。
测试环境:NVIDIA H800 PCIe(114 个 SM),驱动 590.48.01,CUDA Toolkit 13.0.88。 主 Python 环境为 PyTorch 2.11.0+cu130、FA3 3.0.0、TileLang 0.1.9 和 Triton 3.6.0。 WS 对照使用 PyTorch 2.10.0+cu128 及 Triton 3.8.0+gita59d32fd。 准确的依赖版本和代码生成选项见可下载的版本清单。
每个单元格为延迟中位数(毫秒)/ TFLOPS。每个实现、每个尺寸独立预热并测量三轮, 每轮预热 50 次、使用 CUDA event 计时 200 次执行。FA3 在整个测试序列的首尾各测三轮, 因此表中的 FA3 中位数来自六个样本。
| 实现 | S=4096 ms / TFLOPS | S=8192 ms / TFLOPS | S=16384 ms / TFLOPS |
|---|---|---|---|
| FlashAttention-3 | 1.3944 / 394.3 | 5.3025 / 414.7 | 20.7054 / 424.8 |
| Croqtile v1:顺序执行 | 2.5813 / 213.0 | 9.2858 / 236.8 | 35.3457 / 248.9 |
| Croqtile v2:1p2c TMA(已修复输出) | 1.6600 / 331.2 | 6.1387 / 358.2 | 23.7090 / 371.0 |
| Croqtile v4:非持久化重叠流水线 | 1.4642 / 375.5 | 5.4563 / 403.0 | 21.1821 / 415.3 |
| Croqtile v3:持久化重叠流水线 | 1.3967 / 393.6 | 5.2971 / 415.1 | 20.7939 / 423.0 |
| TileLang:128 x 128,2 个阶段 | 1.6511 / 333.0 | 6.2546 / 351.6 | 24.2038 / 363.4 |
| Triton 3.6:自动调优,无 WS | 1.7542 / 313.4 | 6.6744 / 329.5 | 25.9039 / 339.6 |
| Triton main:Hopper WS,带掩码循环 | 1.9217 / 286.1 | 6.9654 / 315.7 | 26.6264 / 330.4 |
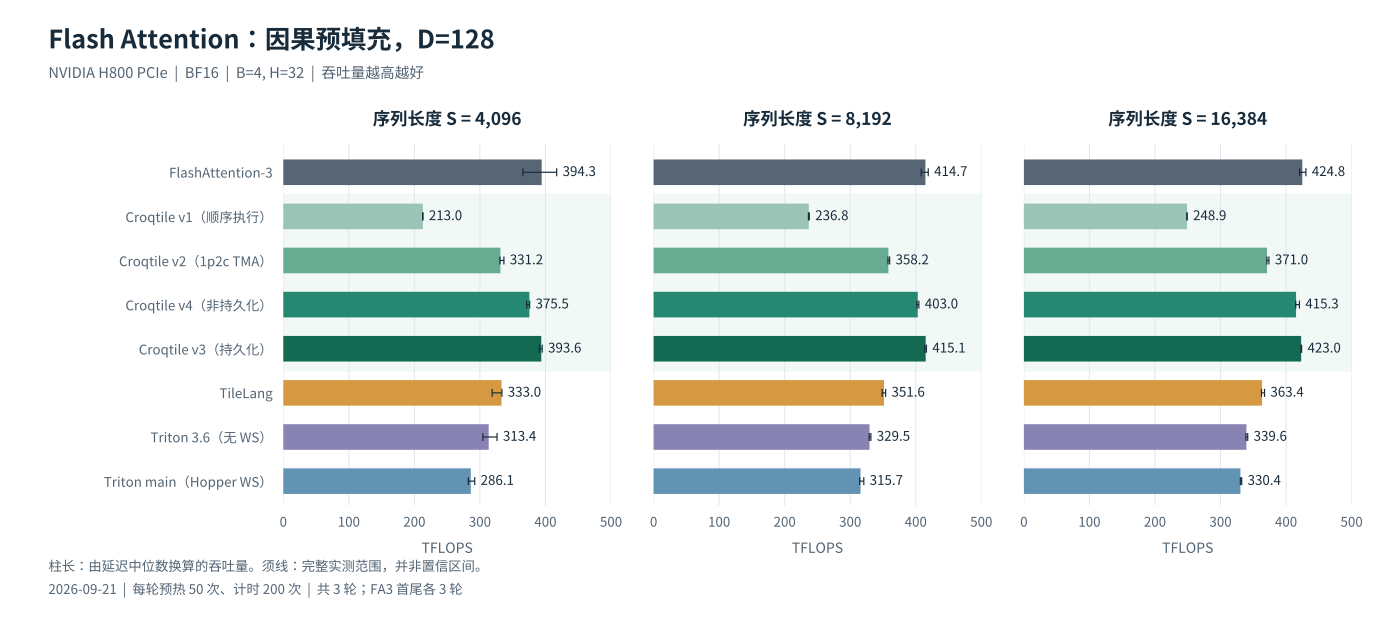
柱长表示由延迟中位数换算的吞吐量,须线表示完整实测范围,而不是置信区间。
三栏使用相同且从零起算的坐标尺度。图表由实测 CSV
通过可下载的绘图脚本直接生成,中文标注使用 --language zh。
本次 S=8192 测量中,v4 和 v3 相对顺序执行的 v1 分别达到 1.70 倍和 1.75 倍性能。 此尺寸下 v3 与 FA3 的中位数基本持平,差距小于下文记录的 FA3 漂移。 这里比较的是包内这些实现和配置,不代表各库能达到的最佳性能。
计时范围与比较限制
所有实现的输入和输出均为 BF16,使用 FP32 累加和因果掩码。 旧 Triton 脚本使用 FP16;包内版本已统一为 BF16,并单独通过正确性检查。 Triton 使用连续的 BHSD 张量,一次性的 BSHD/BHSD 转换不计入耗时;其他实现直接使用 BSHD。 因此该对比不包含布局转换成本。
计时不使用 CUDA Graphs。编译、自动调优、输入准备、正确性检查及 v3 的首次调度器初始化不计入耗时。 Python 的输出分配及包装层发起工作仍在重复调用内,主机发起间隙可能影响 CUDA event 测得的时间。 这些是预热后的调用耗时,不是应用端到端延迟。
更新后的 Triton+WS 使用设备端 tensor descriptor 和 tl.range(warp_specialize=True)。
本次使用的编译器已不接受旧 aref 启动选项。单个带掩码的因果循环避开了该版本编译器处理旧分段循环时的错误;
包装层要求生成 12 个 warp(384 个线程),以防悄悄退化为非 WS 实现。
这一行不是旧 aref 实现的重测结果。
测试未锁定 GPU 时钟,各实现串行运行。脚本在每个实现开始前等待温度降至不高于 65 摄氏度, 但这不保证测量期间温度恒定。FA3 首尾各组三个样本的中位数如下:
| 序列长度 | 测试前 FA3(ms) | 测试后 FA3(ms) | 变化 |
|---|---|---|---|
| 4096 | 1.3908 | 1.3980 | +0.52% |
| 8192 | 5.2543 | 5.3796 | +2.39% |
| 16384 | 20.5006 | 20.8591 | +1.75% |
S=4096 时,FA3 的六个样本分布在 1.3180–1.5034 ms;较短序列尤其容易受调用波动影响。 不要把很小的百分比差距解读为确定的性能优势。 所有样本、最小/最大值、GPU 状态和源码 SHA-256 均保存在 results.json 和 summary.csv 中, 压缩包还保留全部原始验证和计时日志。
吞吐量按近似的有效因果 QK 与 PV 运算量计算:
TFLOPS = 2 * B * H * S * S * D / (milliseconds * 1e9)。
该公式不包含标量 softmax 运算及对角 tile 内额外执行的运算。
正确性检查
所有八个实现在全部三个尺寸上通过正确性检查后,才接受其计时结果。 每次 Choreo 检查抽样验证 4096 个输出元素,包含有针对性的尾部 query 行。 Python 对照实现对每个尺寸检查 261760–262016 个输出元素: 在每个 batch/head 中选取包含 tile 边界和序列尾部的若干行,与显式 FP32 attention 参考结果比较。 该参考计算禁用 TF32。
两个测试框架都使用 abs(error) <= 0.05 + 0.1 * abs(reference)。
观察到的最大绝对误差:Choreo 不超过 0.00203,Python 对照不超过 0.00298。
这是抽样验证,而非逐元素全量检查。
两个框架均采用随机种子 42,Q/K 在 [-2,2] 上均匀分布,V 在 [-1,1] 上均匀分布;
C++ 与 PyTorch 的随机数生成器不同,因此输入不保证逐位相同。
下载与复现
下载 standalone ZIP 或 tar.gz。 两者包含相同的源码、脚本、runtime 头文件和测量结果。 可用 SHA-256 校验和核对压缩包; 依赖、许可证和测量约定见包内 README。
tar -xzf flash-attention-standalone.tar.gz
cd flash-attention-standalone
export CUDA_HOME=/usr/local/cuda
export CUTE_HOME=/path/to/cutlass

# Builds the included CUDA and verifies/times all four Choreo kernels.
bash run.sh --gpu 0 --backends v1,v2,v4,v3

# Full comparison, including the separate Triton+WS environment.
bash run.sh --gpu 0 \
  --python /path/to/main-environment/bin/python \
  --ws-python /path/to/triton-ws-environment/bin/python
默认构建不需要 Choreo 编译器。如果修改了 .co 内核,需要使用兼容的编译器重新生成 CUDA:
bash run.sh --build-only --regenerate --backends v4 \
  --choreo /path/to/choreo
bash run.sh --skip-build --gpu 0 --backends v4
默认每个尺寸测量三轮,每轮预热 50 次、重复执行 200 次,可通过 --warmup、--repeat 和 --rounds 调整。
每次运行会新建 results/<UTC timestamp>/ 目录,保存原始日志、results.json、summary.csv 和 summary.md。
若正确性检查失败或指定实现不可用,脚本会终止测试,并把已有的部分结果标记为未完成;
不会悄悄替换成其他实现。
可检查 generated/ 中的 CUDA,确认 TMA 完成绑定、WGMMA 发起和等待位置、K/V 释放时机、
最终分母归约及输出写回。构建生成的资源报告位于 build/*-nvcc.log。
构建后,可用下面的命令分析独立版 v4:
CUDA_VISIBLE_DEVICES=0 MHA_SEQ=8192 CHOREO_DISABLE_TIMING=1 \
  ncu --set full --launch-count 1 \
  -o build/v4-s8192 build/v4
这里通过 MHA_SEQ 显式选择负载;可执行文件先启动 attention 内核,再执行 CPU 参考检查。
始终核对 profiler 捕获的内核名称和尺寸。
继续调优时,每次只改变一个方面,例如 tile 形状、缓冲阶段数、释放位置、缓存提示或任务顺序。 保留改动前,应检查生成代码并重新测量全部三个尺寸。 寄存器更少、阶段更多或改用持久化网格,只有在满足正确性的前提下改善实测耗时才有意义。
迁移旧版 attention 代码
| 旧写法或旧假设 | 当前写法或解释 |
|---|---|
在 tma.copy.async<event> 中内联事件 |
load = tma.load.async ...; trigger event after load; |
源码中显式使用 mma.wait<N> |
op = mma.row.row.async ...; wait op; |
| 用物理数据槽位索引事件 | 事件使用 event.at(logical_order);数据仍使用 [logical_order % stages] |
| 手动初始化空槽环 | 优先使用 shared event empty[N] = ready,不要重复初始化 |
| 首次迭代执行占位 PV | 分离 QK 序言、QK/PV 稳态循环及最终 PV |
| 每个事件都对应 named barrier | 后端依据参与者推导同步原语 |
| 持久化调度仍是未来工作 | 当前 v3 已包含由主机构建的持久化任务列表 |
本例使用的 future 语义 和事件语义均提供可下载的参考快照。 源码清单记录代码生成选项和版本, 测量记录保存实际内核、生成 CUDA 及 runtime 头文件的 SHA-256。 编译器开发和安装说明见 Croqtile 开源仓库。